Teknologi
OpenAI Jalapeño: Spek Chip Banding Nvidia GB300
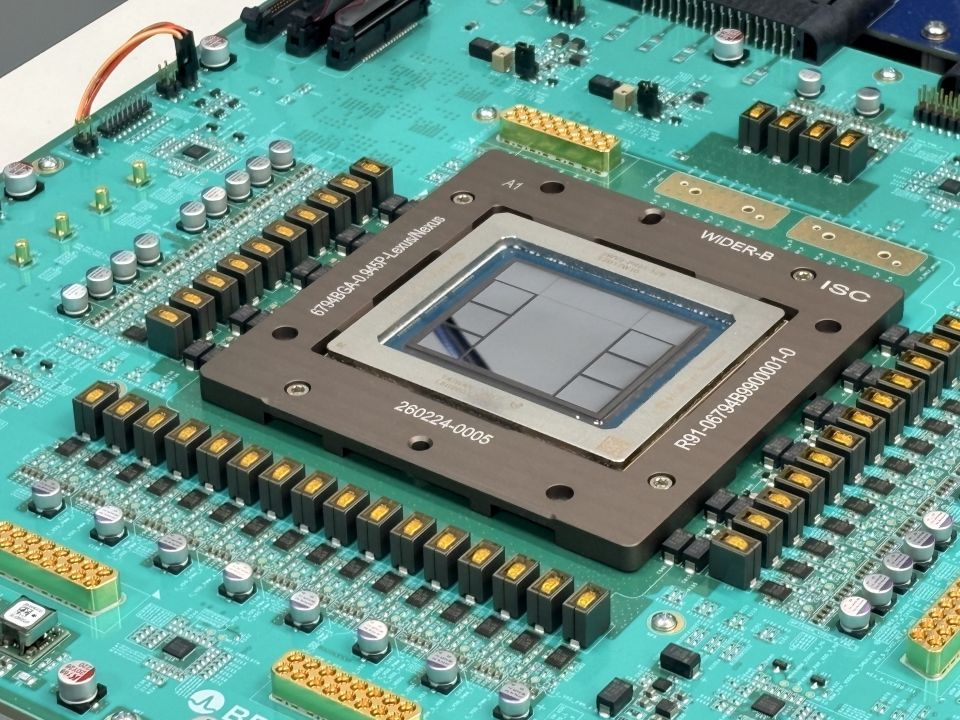
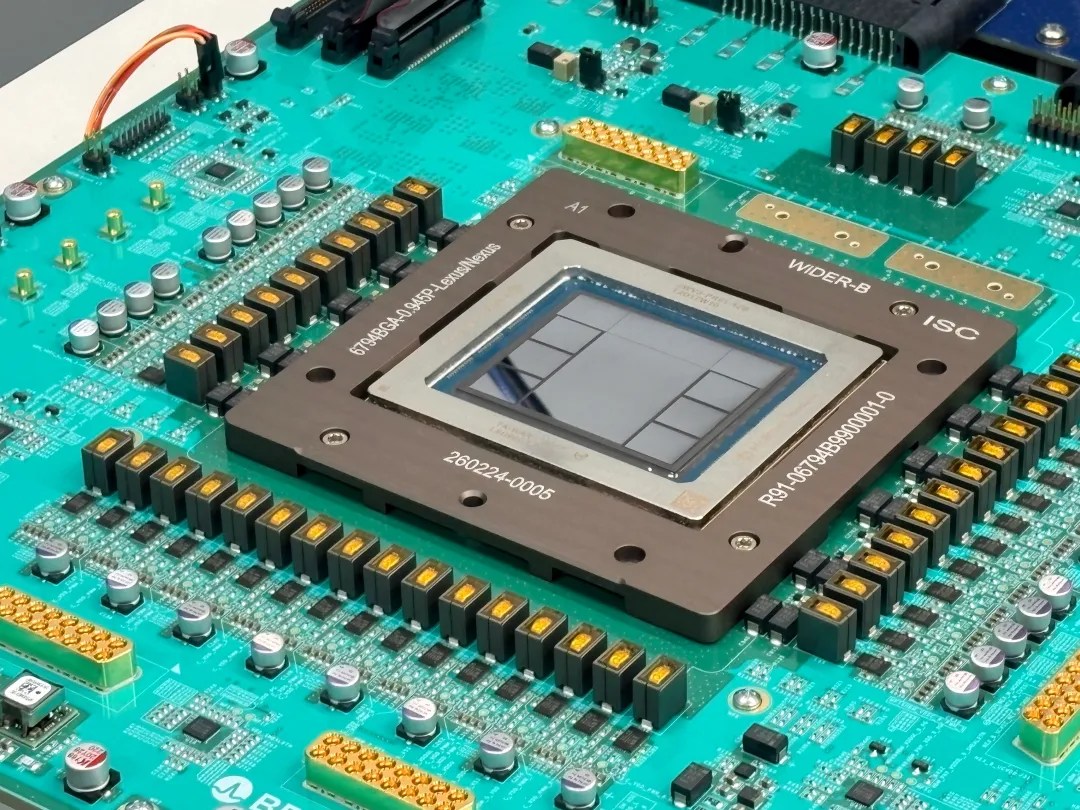
OpenAI Jalapeño ASIC inference: spek HBM4 216 GiB, 700W, banding InferenceX vs Nvidia GB200/GB300, jadwal deploy akhir 2026, plus reaksi komunitas.

OpenAI merinci Jalapeño, chip ASIC inference buatan sendiri, di Hot Chips 2026 dan mempublikasikan hasil pertama di blog resmi. Ini adalah akselerator khusus untuk menjalankan model (bukan training), dikerjakan bersama Broadcom, dengan board dan rack dari Celestica.
Artikel ini akan menjelaskan spesifikasi chip, perbedaannya dengan Nvidia GB200/GB300 di benchmark InferenceX, bagaimana arsitektur homogen dipakai untuk prefill–draft–verify, jadwal deploy akhir 2026 sampai 2027, reaksi di Hacker News dan Reddit, plus catatan praktis buat yang pantau harga token dan infrastruktur AI dari Indonesia.
Apa yang diluncurkan dan kenapa penting

Jalapeño pertama kali disebut publik sekitar Juni 2026. Di Hot Chips, Richard Ho, Ravi Narayanaswami, dan Chris Leary membuka angka spek plus kurva latency–throughput. OpenAI menyebut chip ini “Intelligence Processor”: satu silikon seimbang untuk seluruh siklus serving agentic, bukan armada chip khusus per fase.
Ini penting karena inference — proses menjalankan model yang sudah dilatih — kini memakan porsi biaya dan daya yang besar di data center AI. Training tetap mahal, tapi volume serving ChatGPT, agen, dan API jauh lebih sering. Siapa yang bisa menurunkan watt per token dan latency per respons punya keunggulan produk dan margin.
Ringkasan peluncuran yang relevan:
- ASIC inference first-party — OpenAI masuk klub hyperscaler dengan silikon sendiri (sejajar TPU Google, Trainium/Inferentia Amazon, MTIA Meta)
- Partner silikon Broadcom — die utama; Celestica mengurus board dan rack
- Host AMD EPYC Turin — bukan CPU Nvidia Vera; Jalapeño duduk di sisi OpenAI, Nvidia tetap partner training dan sebagian inference
- Deploy bertahap — volume kecil akhir 2026, naik di 2027; Gen 2 menuju tape-out, Gen 3 sudah dalam pengerjaan
- Fokus efisiensi + latency — bukan “ganti semua GPU Nvidia di dunia”
- Benchmark publik InferenceX — banding kurva latency–throughput terhadap frontier GB200/GB300 di model open, bukan hanya slide puncak FLOPS
Catatan: Angka banding di artikel ini mengikuti materi OpenAI dan liputan outlet (Tom’s Hardware, ServeTheHome, The Verge, TechCrunch, RCR). Beberapa benchmark dijalankan OpenAI sendiri di atas suite publik InferenceX; komunitas minta hati-hati karena ini early silicon dan angka vendor.
Spek hardware yang perlu diingat

Berikut ringkasan spek yang sering dikutip dari slide Hot Chips dan artikel teknis:
| Item | Jalapeño (per chip) |
|---|---|
| Compute matrix | 13,4 PFLOPS MXFP4 × MXFP4; hingga 3,4 PFLOPS MXFP8 |
| Memori | 216 GiB HBM4 (enam stack) |
| Bandwidth HBM | 15,4 TB/s |
| Daya paket (TDP) | 700 W (sustained terukur ≤ 550 W di beban uji) |
| Clock | 1,70 GHz di silikon lab; target naik ke 1,80 GHz |
| Iris arsitektur | 64 core/HBM slice, gaya NUMA / spatial |
| Domain lokal | 128 ASIC, interconnect ~600 GB/s |
| Pod global | 2.048 ASIC / 16 rack, ~200 GB/s per chip via Broadcom Tomahawk 6 (Clos half-flattened) |
| Aggregate pod | ~27 EFLOPS MXFP4, 432 TiB HBM4, ~32 PB/s bandwidth agregat |
OpenAI menekankan bottleneck bukan “tambah HBM tanpa batas”, melainkan mengekspos bandwidth HBM yang sudah ada tanpa contention. Tiap core slice dipasangkan dengan slice HBM lokal supaya latency prediktabel. Ada jaringan kolektif cepat register-to-register untuk pola komunikasi umum, plus NoC umum yang sengaja lebih “kurus” untuk traffic yang jarang.
Banding InferenceX vs Nvidia GB200/GB300
OpenAI memakai InferenceX (SemiAnalysis): suite publik yang membandingkan kurva latency versus throughput, dinormalisasi ke TDP paket. Model uji yang disebut di blog dan slide:
- GPT-OSS 120B — tekanan latency
- DeepSeek R1 670B — kasus draft/speculative yang bagus
- Kimi K2.5 1T — uji skala multi-device
Hasil headline yang dikutip OpenAI di ketiga model:
- 1,5×–1,9× lebih banyak kerja AI per watt di puncak throughput
- 1,7×–3,6× lebih rendah end-to-end latency
- 2,1×–4,1× lebih baik di metrik time-between-tokens (TBT) minimum pada beberapa titik operasi
- Di titik TBT terbaik lawan, angka throughput bisa terlihat ekstrem (hingga ~104× di DeepSeek R1) — itu bukan “104× lebih cepat overall”, melainkan throughput di operating point latency terendah lawan
Perbandingan yang lebih “adil” juga ditampilkan: Jalapeño single-token versus GB300 dengan multi-token prediction. Margin menyusut (kira-kira 1,5× peak mixed token/kW dan 2,2× latency lebih rendah di DeepSeek), tapi masih positif menurut slide.
Richard Ho bilang chip ini memberi “best of both worlds”: latency rendah dan throughput tinggi, padahal sistem lama sering harus memilih satu. Rencana deploy: volume kecil akhir 2026, ramp 2027. Nvidia tidak diganti total — OpenAI tetap memakai “very good partners”.
Peringatan: Banding per-watt memfavoritkan chip 700 W melawan 1.200–1.400 W. Absolute peak PFLOPS Nvidia di atas kertas bisa lebih tinggi; yang dijual OpenAI adalah efisiensi serving interaktif dan cost per token di data center mereka sendiri.
Arsitektur homogen: satu chip untuk tiga fase
Permintaan agentic modern punya tiga rezim hardware berbeda:
- Prefill — cenderung compute-bound
- Draft (spekulasi) — latency-bound, batch kecil
- Verify / decode — memory-bandwidth-bound, komunikasi MoE bursty
Nvidia sering membagi prefill vs decode ke perangkat berbeda (contoh arah Rubin CPX + GPU HBM). OpenAI memilih satu ASIC seimbang: rasio compute/memori/network yang aktif berubah di dalam chip, unit idle digate, KV cache tetap lokal. Argumennya: armada heterogen sering bayar daya dasar chip yang menganggur, plus biaya pindah KV antar mesin.
Pemrograman memakai ekosistem Triton / kerangka Gluon: tiap core fisik diprogram sebagai thread block, layout tensor eksplisit. Software harus “tahu” di mana tensor fisik berada di slice HBM, lalu mengatur komunikasi kolektif. Itu lebih ribet dari CUDA hitam-kotak, tapi OpenAI bilang model frontier justru bagus mencari placement dan scheduling.
OpenAI mengaku AI internal mengubah kernel fungsional jadi implementasi cepat (1,5×–1,8× vs kernel ahli yang sudah ada, menurut slide). Trade-off-nya: mapping optimal bergantung arsitektur. Kalau Gen 2 mengubah jumlah core atau topologi jaringan, pola penempatan lama bisa kurang optimal dan perlu dioptimasi ulang — beda dengan janji kompatibilitas CUDA lintas generasi GPU.
Siklus desain juga dipercepat AI: RTL awal sekitar Februari 2025, tape-out November 2025, first silicon Mei 2026, Codex berjalan di Jalapeño bulan yang sama — kira-kira sembilan bulan dari RTL ke chip hidup. Lebih dari separuh core ditulis dengan XLS; OpenAI melaporkan gain PPA versus baseline manusia (contoh 56% di multiplier BF16, 21% di blok FP4 dot-product, area matrix unit lebih kecil ~10%). Richard Ho menekankan sebagian besar RTL ditulis baru, meski beberapa interface IP Broadcom dipakai ulang.
Baca juga Spotify Premium Naik Harga? Ini Daftar Harga November 2026
flowchart LR
  A[Request agentic] --> B[Prefill compute]
  B --> C[Draft latency]
  C --> D[Verify / decode bandwidth]
  D --> E[Token ke user]
  B -. KV lokal .-> D
  C -. unit idle digate .-> D
Reaksi komunitas: antusias tapi skeptis
Di Hacker News (thread SemiAnalysis, ratusan poin dan ratusan komentar), nada dominan bukan “OpenAI menang mutlak”, melainkan cek ulang metodologi:
- Banyak yang bilang judul “better than Blackwell” terlalu sederhana: Jalapeño inference-only, lawan sering GPU serbaguna
- Kritik ke SemiAnalysis: angka dari OpenAI, early A0 silicon, kurang “lab independen”
- Perbandingan yang lebih relevan ke depan: Vera Rubin / generasi HBM4 Nvidia, bukan hanya GB200/GB300
- Google TPU dan chip AMD inference sering disebut “hilang dari tabel”
- Ada juga yang menekankan leverage bisnis: silikon sendiri = bargaining chip ke Nvidia, meski training tetap di GPU
Di Reddit (thread seputar claim outperform Nvidia), pola sama: efficiency menarik, tapi tunggu volume produksi dan angka pihak ketiga. Komentar ServeTheHome menyoroti siklus sembilan bulan RTL→ChatGPT di chip sebagai sinyal bahwa AI-assisted chip design sudah nyata, bukan slide marketing kosong.
Tips: Kalau membaca “104×”, langsung cek konteks operating point. Angka itu sering dipakai di headline media; isi teknisnya lebih berhati-hati.
Yang relevan buat yang pantau dari Indonesia
Chip ini tidak dijual ke toko atau cloud umum seperti GPU consumer. Dampaknya ke Indonesia lewat jalur tidak langsung, tapi tetap terasa buat yang bayar API, bangun agen, atau ikut berita infrastruktur.
- Harga token API — kalau cost/watt OpenAI turun, ada ruang harga ChatGPT/API lebih murah atau margin lebih tebal (OpenAI bisa memilih keduanya)
- Latency agen — produk agentic (Computer Use, coding agent, voice) lebih responsif kalau serving di silikon khusus
- Persaingan cloud Indo/Asia — GCP TPU, AWS Trainium, Azure + Nvidia tetap opsi; Jalapeño memperkuat OpenAI di stack sendiri, bukan mengganti akses Indo ke GPU sewa
- Startup lokal — yang self-host model open-weight tetap di jalur CUDA/ROCm/Ascend; Jalapeño tidak mengubah toolchain lokal minggu ini
- Berita spek tahan lama — query “spek Jalapeño / banding Nvidia” tetap dicari sampai Gen 2/3 keluar, cocok jadi referensi Indo yang jarang ditulis panjang
Untuk tim yang bayar dolar ke OpenAI API dari Indo, praktik yang masuk akal minggu ini:
- Cek changelog harga model (Luna, Sol, dan keluarga GPT-OSS) sebelum memperpanjang kontrak seat
- Ukur latency nyata dari server Indo/Singapura, bukan hanya slide Hot Chips
- Pisahkan workload training vs serving di arsitektur sendiri — Jalapeño tidak mengubah fakta bahwa training frontier masih di GPU partner
- Kalau membangun agen untuk UMKM atau creator, fokus ke harga token + kuota, bukan spek rack 2.048 chip
Chip baru jarang muncul sebagai line item invoice. Yang sering berubah lebih dulu adalah kuota mingguan, harga per juta token, atau “rasa” respons agen yang lebih snappy di jam ramai. Itu sinyal tidak langsung bahwa efisiensi serving naik — bisa dari Jalapeño, software stack, atau campuran keduanya.
Checklist
- Bedakan klaim per watt vs absolute PFLOPS saat baca berita Jalapeño vs Nvidia
- Catat spek inti: 216 GiB HBM4, 15,4 TB/s, 13,4 PFLOPS MXFP4, TDP 700 W
- Ingat skala: 128 chip lokal, 2.048 chip pod
- Tandai jadwal: volume kecil akhir 2026, ramp 2027
- Baca ulang angka ekstrem (~104×) dengan konteks operating point TBT
- Untuk API Indo: pantau harga token + latency regional, bukan SKU chip
Poin penting
- Jalapeño adalah ASIC inference OpenAI pertama; Broadcom (silikon) + Celestica (board/rack); host AMD EPYC Turin
- Spek kunci: 216 GiB HBM4, 15,4 TB/s, 13,4 PFLOPS MXFP4, TDP 700 W
- Skala: 128 chip lokal → 2.048 chip pod (~27 EFLOPS, 432 TiB)
- InferenceX vs GB200/GB300: sekitar 1,5–1,9× kerja/watt dan 1,7–3,6× latency lebih rendah (angka OpenAI)
- Arsitektur homogen untuk prefill/draft/verify; KV tidak dipindah antar chip khusus
- Deploy kecil akhir 2026, ramp 2027; Nvidia tetap partner; Gen 2/3 menyusul
- Komunitas minta hati-hati: early silicon, banding per-watt, lawan ideal mungkin Rubin/TPU
Referensi
- OpenAI (2026). Jalapeño’s first results show industry-leading speed and efficiency in AI inference
- Tom’s Hardware (2026). Hot Chips 2026: OpenAI’s Jalapeño AI ASIC unpacked
- ServeTheHome (2026). OpenAI Jalapeno Custom AI ASIC at Hot Chips 2026
- The Verge (2026). OpenAI says its Jalapeño chip can power faster AI responses than the competition
- TechCrunch (2026). OpenAI’s Jalapeño chip is built for fast inference at scale, benchmarks show
- RCR Wireless News (2026). OpenAI details its Jalapeño AI chip specs at Hot Chips
- NAND Research (2026). OpenAI’s Jalapeño Inference Accelerator
- SemiAnalysis / InferenceX (2026). OpenAI Jalapeño: Better than Nvidia Blackwell
- Hacker News (2026). Discussion: OpenAI Jalapeño Better than Nvidia Blackwell
- Reddit r/NVDA_Stock (2026). OpenAI Says New Jalapeno Chips Outperformed Nvidia in Testing
- LavX News (2026). OpenAI’s Jalapeño Chip Challenges Nvidia with Homogeneous Inference Design
- Bloomberg coverage cited in HN (2026). OpenAI custom chip financing and partner notes
Pertanyaan Umum
Apa bedanya Jalapeño dengan GPU Nvidia biasa?
Apakah angka 1,9× per watt berarti ChatGPT akan 1,9× lebih cepat di Indo?
Kapan Jalapeño dipakai di produksi?
Bisakah perusahaan Indonesia membeli chip Jalapeño?
Kenapa komunitas HN skeptis meski spek kelihatan kuat?
Apa dampaknya ke harga token API?
Kesimpulan
Jalapeño menandai langkah serius OpenAI ke silikon inference sendiri: spek HBM4 agresif, daya 700 W, skala sampai 2.048 chip per pod, dan klaim efisiensi–latency yang menantang GB200/GB300 di InferenceX. Arsitektur homogen untuk tiga fase request, plus siklus desain yang dibantu AI, membuat cerita ini lebih dari sekadar “ASIC baru”.
Untuk pembaca di Indonesia, yang paling berguna adalah memahami spek, batas klaim banding, dan jalur dampak tidak langsung ke harga token serta respons agen — bukan berharap chip ini muncul di marketplace lokal minggu ini. Nvidia belum digeser dari training; kompetisi inference baru saja makin ramai.
Komentar (0)
Belum ada komentar. Jadilah yang pertama berbagi pendapat!
Tinggalkan komentar