Kecerdasan Buatan
Strata Bikin Qwen 3.8 Flash Next Bisa Jalan di PC Gaming, Modal RTX 12 GB dan RAM 32 GB
Strata menjalankan Qwen 3.8 Flash Next 125B di PC gaming dengan RTX 12 GB. Simak kebutuhan RAM, kecepatan, pilihan model, dan hitungan biayanya di Indonesia.
Model AI berukuran 125 miliar parameter biasanya identik dengan server berisi GPU kelas data center. Sekarang ada proyek open source bernama Strata yang membuat Qwen 3.8 Flash Next bisa berjalan di PC gaming biasa, cukup dengan kartu grafis 12 GB dan RAM mulai 32 GB. Proyek ini sempat menempati posisi kedua Hacker News pada 4 Oktober 2026 dengan hampir 800 poin dan lebih dari 350 komentar.
Artikel ini akan menjelaskan apa sebenarnya Strata, kenapa model sebesar itu bisa muat di kartu kelas menengah, spek minimal dan pilihan model sesuai RAM, angka kecepatan resmi dibanding laporan komunitas, perbedaannya dengan Ollama dan llama.cpp biasa, serta hitungan kasar biayanya kalau mau merakit PC AI lokal di Indonesia.
Strata dan Qwen 3.8 Flash Next: apa yang baru minggu ini
Strata adalah mesin inferensi (inference engine) yang dibuat khusus untuk satu model, yaitu Qwen3.8-Flash-Next dari tim Qwen Alibaba. Repositori GitHub-nya, Niko1221/Strata, baru dibuka pada 24 September 2026, lalu meledak dalam sepuluh hari. Saat artikel ini ditulis, jumlah bintangnya sudah menembus 12 ribu.
Beberapa hal yang membuat proyek ini cepat jadi bahan obrolan:
- Installer sekali klik. Di Windows cukup menjalankan
START-HERE.bat, sedangkan di Linux memakaisetup.sh. Installer akan mengecek GPU, RAM, dan disk, lalu memilihkan ukuran model yang pas. - Gratis dan berlisensi MIT untuk mesinnya. Bobot modelnya tetap mengikuti lisensi masing-masing.
- API lokal yang kompatibel dengan format OpenAI, OpenAI Responses (untuk Codex CLI), dan Anthropic Messages, semuanya di
127.0.0.1:8080. - Versi terbaru v0.1.39 dirilis pada 4 Oktober 2026. Versi ini menambah dukungan permintaan paralel, endpoint
/v1/responses, serta dukungan eksperimental untuk GPU lama seperti GTX 10, Tesla P40, dan Intel Arc di Linux.
Modelnya sendiri bukan barang baru. Qwen3.8-Flash-Next dirilis di Hugging Face pada akhir Agustus 2026 dan sudah diunduh sekitar 1,48 juta kali. Yang baru adalah cara menjalankannya: selama ini model ini dianggap terlalu besar untuk PC rumahan, dan Strata mematahkan anggapan itu.
Catatan: Strata hanya menjalankan satu keluarga model, yaitu Qwen3.8-Flash-Next beserta varian kuantisasinya. Ini berbeda dengan Ollama atau LM Studio yang bisa memuat ratusan model.
Kenapa model 125B bisa muat di kartu grafis 12 GB

Kuncinya ada pada arsitektur model. Qwen3.8-Flash-Next adalah model Mixture of Experts (MoE). Total parameternya memang 125 miliar, tetapi untuk setiap token hanya sekitar 6 miliar parameter yang benar-benar aktif. Model ini punya 512 expert per lapisan di 48 lapisan, dan setiap token hanya membangunkan 10 expert plus 1 expert bersama.
Strata memanfaatkan sifat itu dengan membagi model ke seluruh bagian PC:
- VRAM kartu grafis menyimpan beberapa ribu expert yang paling sering dipanggil.
- RAM sistem menyimpan semua expert. Kalau expert yang dibutuhkan tidak ada di GPU, prosesor ikut menghitungnya.
- SSD menyimpan tabel n-gram embedding berukuran 51 miliar parameter. Tabel ini cuma dibaca beberapa baris per kata, jadi SSD masih sanggup melayaninya.
Di atas pembagian itu, Strata memakai kepala prediksi multi-token (MTP) bawaan model untuk speculative decoding. Cara kerjanya mirip menebak lalu mengecek: bagian kecil menebak beberapa kata berikutnya, lalu model besar memeriksa semuanya sekaligus. Menurut dokumentasi proyek, trik ini membuat jawaban keluar 1,6 sampai 1,8 kali lebih cepat dengan hasil yang sama.
flowchart LR
  A[Prompt dari aplikasi atau agen] --> B[Strata server :8080]
  B --> C[VRAM: expert paling sering dipakai]
  B --> D[RAM: semua expert, CPU bantu hitung]
  B --> E[SSD: tabel n-gram 51B]
  C --> F[Jawaban + tebakan MTP dicek sekaligus]
  D --> F
  E --> F
Satu catatan penting: model ini tetap dikompresi lewat kuantisasi supaya muat. Versi yang dipakai Strata berasal dari ISTA-DASLab (metode GSQ-RCO), dengan ukuran mulai dari sekitar 2 bit sampai 3 bit per bobot. Inilah sumber perdebatan terbesar di komunitas, yang akan dibahas di bagian berikutnya.
Spek minimal dan pilihan model sesuai RAM
Strata menuliskan kebutuhan hardware dengan cukup jelas. Berikut ringkasannya:
| Komponen | Kebutuhan |
|---|---|
| Kartu grafis | NVIDIA GeForce RTX 20, 30, 40, atau 50; atau AMD Radeon RX 7700 XT ke atas, RX 9060 XT, RX 9070/9070 XT, RX 6800/6900 |
| VRAM | Minimal 12 GB (8 GB bisa jalan, tetapi lambat) |
| RAM | Minimal 32 GB, ideal 64 GB supaya semua ukuran muat |
| Penyimpanan | Sekitar 80 GB kosong, sebaiknya SSD NVMe |
| Sistem operasi | Windows 10/11 atau Linux, driver NVIDIA 580 ke atas |
Besarnya RAM menentukan versi model yang bisa dipakai. Ini tabel rekomendasi resmi dari dokumentasi Strata:
| RAM di PC | Pilihan yang disarankan | Catatan |
|---|---|---|
| 32 GB | Coder | Hanya menyimpan 256 dari 512 expert, kuat untuk kode tetapi lebih lemah untuk bahasa selain Inggris |
| 48 GB | IQ2_XS atau Q2_0 | Ukuran yang lebih besar tidak muat |
| 64 GB | IQ2_XS (disarankan), IQ3_XXS, atau IQ3_S | Semua ukuran muat, IQ3_S paling bagus tetapi paling lambat |
| 96 GB ke atas | IQ3_S atau Unsloth UD-IQ4_XS | Ruang cukup untuk versi sekitar 4 bit |
Ada satu hal yang perlu diperhatikan oleh pengguna Indonesia. Versi Coder memang muat di RAM 32 GB, tetapi dokumentasinya sendiri mengakui versi ini lebih lemah di luar urusan kode, termasuk untuk bahasa selain Inggris. Artinya, kalau tujuannya mengobrol atau merangkum dokumen berbahasa Indonesia, versi penuh seperti IQ2_XS di RAM 48–64 GB jauh lebih masuk akal.
Tips: Saat pertama kali dinyalakan, PC bisa terasa macet 1–3 menit karena Strata memuat 35–55 GB data ke RAM. Menurut dokumentasi, ini normal dan jendelanya sebaiknya tidak ditutup.
Seberapa cepat: angka resmi dan laporan komunitas
Strata menguji dua PC gaming biasa. PC pertama memakai RTX 5070 12 GB, Ryzen 5 7600, dan RAM 64 GB. PC kedua memakai Radeon RX 9070 XT 16 GB, Ryzen 9 3900X, dan RAM 47 GB. Kecepatan menulis jawaban diukur dalam token per detik (satu token kira-kira tiga perempat kata dalam bahasa Inggris).
| Ukuran model | RTX 5070 (tulis jawaban) | RTX 5070 (baca prompt 32K) | RX 9070 XT (tulis jawaban) |
|---|---|---|---|
| Q2_0 | 94 token/s | 2.650 token/s | 60 token/s |
| IQ2_XS | 79 token/s | 2.090 token/s | 52 token/s |
| IQ3_XXS | 62 token/s | 1.750 token/s | – |
| IQ3_S | 53 token/s | 1.620 token/s | – |
| Coder | 55 token/s | 2.180 token/s | 44 token/s |
Angka di atas adalah klaim proyek sendiri, bukan hasil uji independen. Walau begitu, beberapa laporan dari pengguna lain menunjukkan angka yang tidak jauh berbeda:
- Laptop RTX 5070 Ti 12 GB + RAM 64 GB (laporan di r/LocalLLaMA): sekitar 51 token/s pada konteks 43 ribu token dengan IQ3_XXS. Dengan file yang sama, llama.cpp biasa hanya mencapai 23 token/s.
- RTX 4090 + RAM 128 GB (pembuka thread Hacker News): sekitar 124 token/s.
- RTX 4090 D 24 GB + RAM 126 GB (catatan blog seorang developer di Tiongkok): median 100–111 token/s dengan IQ3_S dan konteks 256 ribu token, dengan konsumsi daya GPU 270–300 watt.
- RTX 2060 8 GB (komentar Hacker News): sekitar 33 token/s dengan Q2_0, membuktikan kartu 8 GB pun masih bisa dipakai walau tidak disarankan.
Dokumentasi juga memberi estimasi untuk kartu lain. RTX 5060 Ti 16 GB diperkirakan menulis sekitar 80 token/s dengan Q2_0, sedangkan RTX 3090 24 GB diperkirakan 100–140 token/s. Jadi, besar VRAM lebih berpengaruh daripada kencangnya GPU, karena setiap tambahan 1 GB VRAM bisa menampung sekitar 700 expert tambahan.
Perbedaannya dengan Ollama dan llama.cpp biasa
Pertanyaan yang paling sering muncul adalah: kalau sudah ada Ollama, kenapa harus Strata? Jawabannya ada pada fokus. Strata dibangun di atas sebagian kode llama.cpp/ggml, tetapi semua optimasinya diarahkan ke satu model saja.
| Aspek | Strata | Ollama / llama.cpp biasa |
|---|---|---|
| Model | Hanya Qwen3.8-Flash-Next dan variannya | Ratusan model |
| Pembagian expert | Profil expert khusus, VRAM–RAM–SSD | Offload lapisan umum |
| Speculative decoding | Memakai kepala MTP bawaan model | Tergantung konfigurasi |
| API | OpenAI, Responses, Anthropic Messages | Umumnya OpenAI-compatible |
| Permintaan bersamaan | Default satu, bisa diatur paralel sejak v0.1.39 | Bervariasi |
| Kecepatan pada model ini | Sekitar 2 kali lebih cepat menurut laporan pengguna | Lebih lambat pada file yang sama |
Perbedaan kecepatan itu cukup terasa. Developer pemilik RTX 4090 D tadi menulis bahwa sebelumnya ia memakai Ollama untuk Qwen 3.8 27B, dan pekerjaan analisis kode panjang terasa sangat lambat. Setelah pindah ke Strata dengan model Flash Next, kecepatan menulis jawabannya stabil di atas 100 token/s.
Kekurangannya juga jelas. Strata tidak bisa memuat model lain sesuka hati, tidak menyediakan endpoint embedding, dan secara default hanya melayani satu permintaan dalam satu waktu. Untuk pemakaian pribadi hal ini tidak masalah, tetapi untuk satu tim kecil yang memakai agen coding bersamaan, antreannya bisa cepat penuh.
Baca juga Harga HeyGen Video 1 Naik November, Ini Spek dan Cara Coba Gratisnya
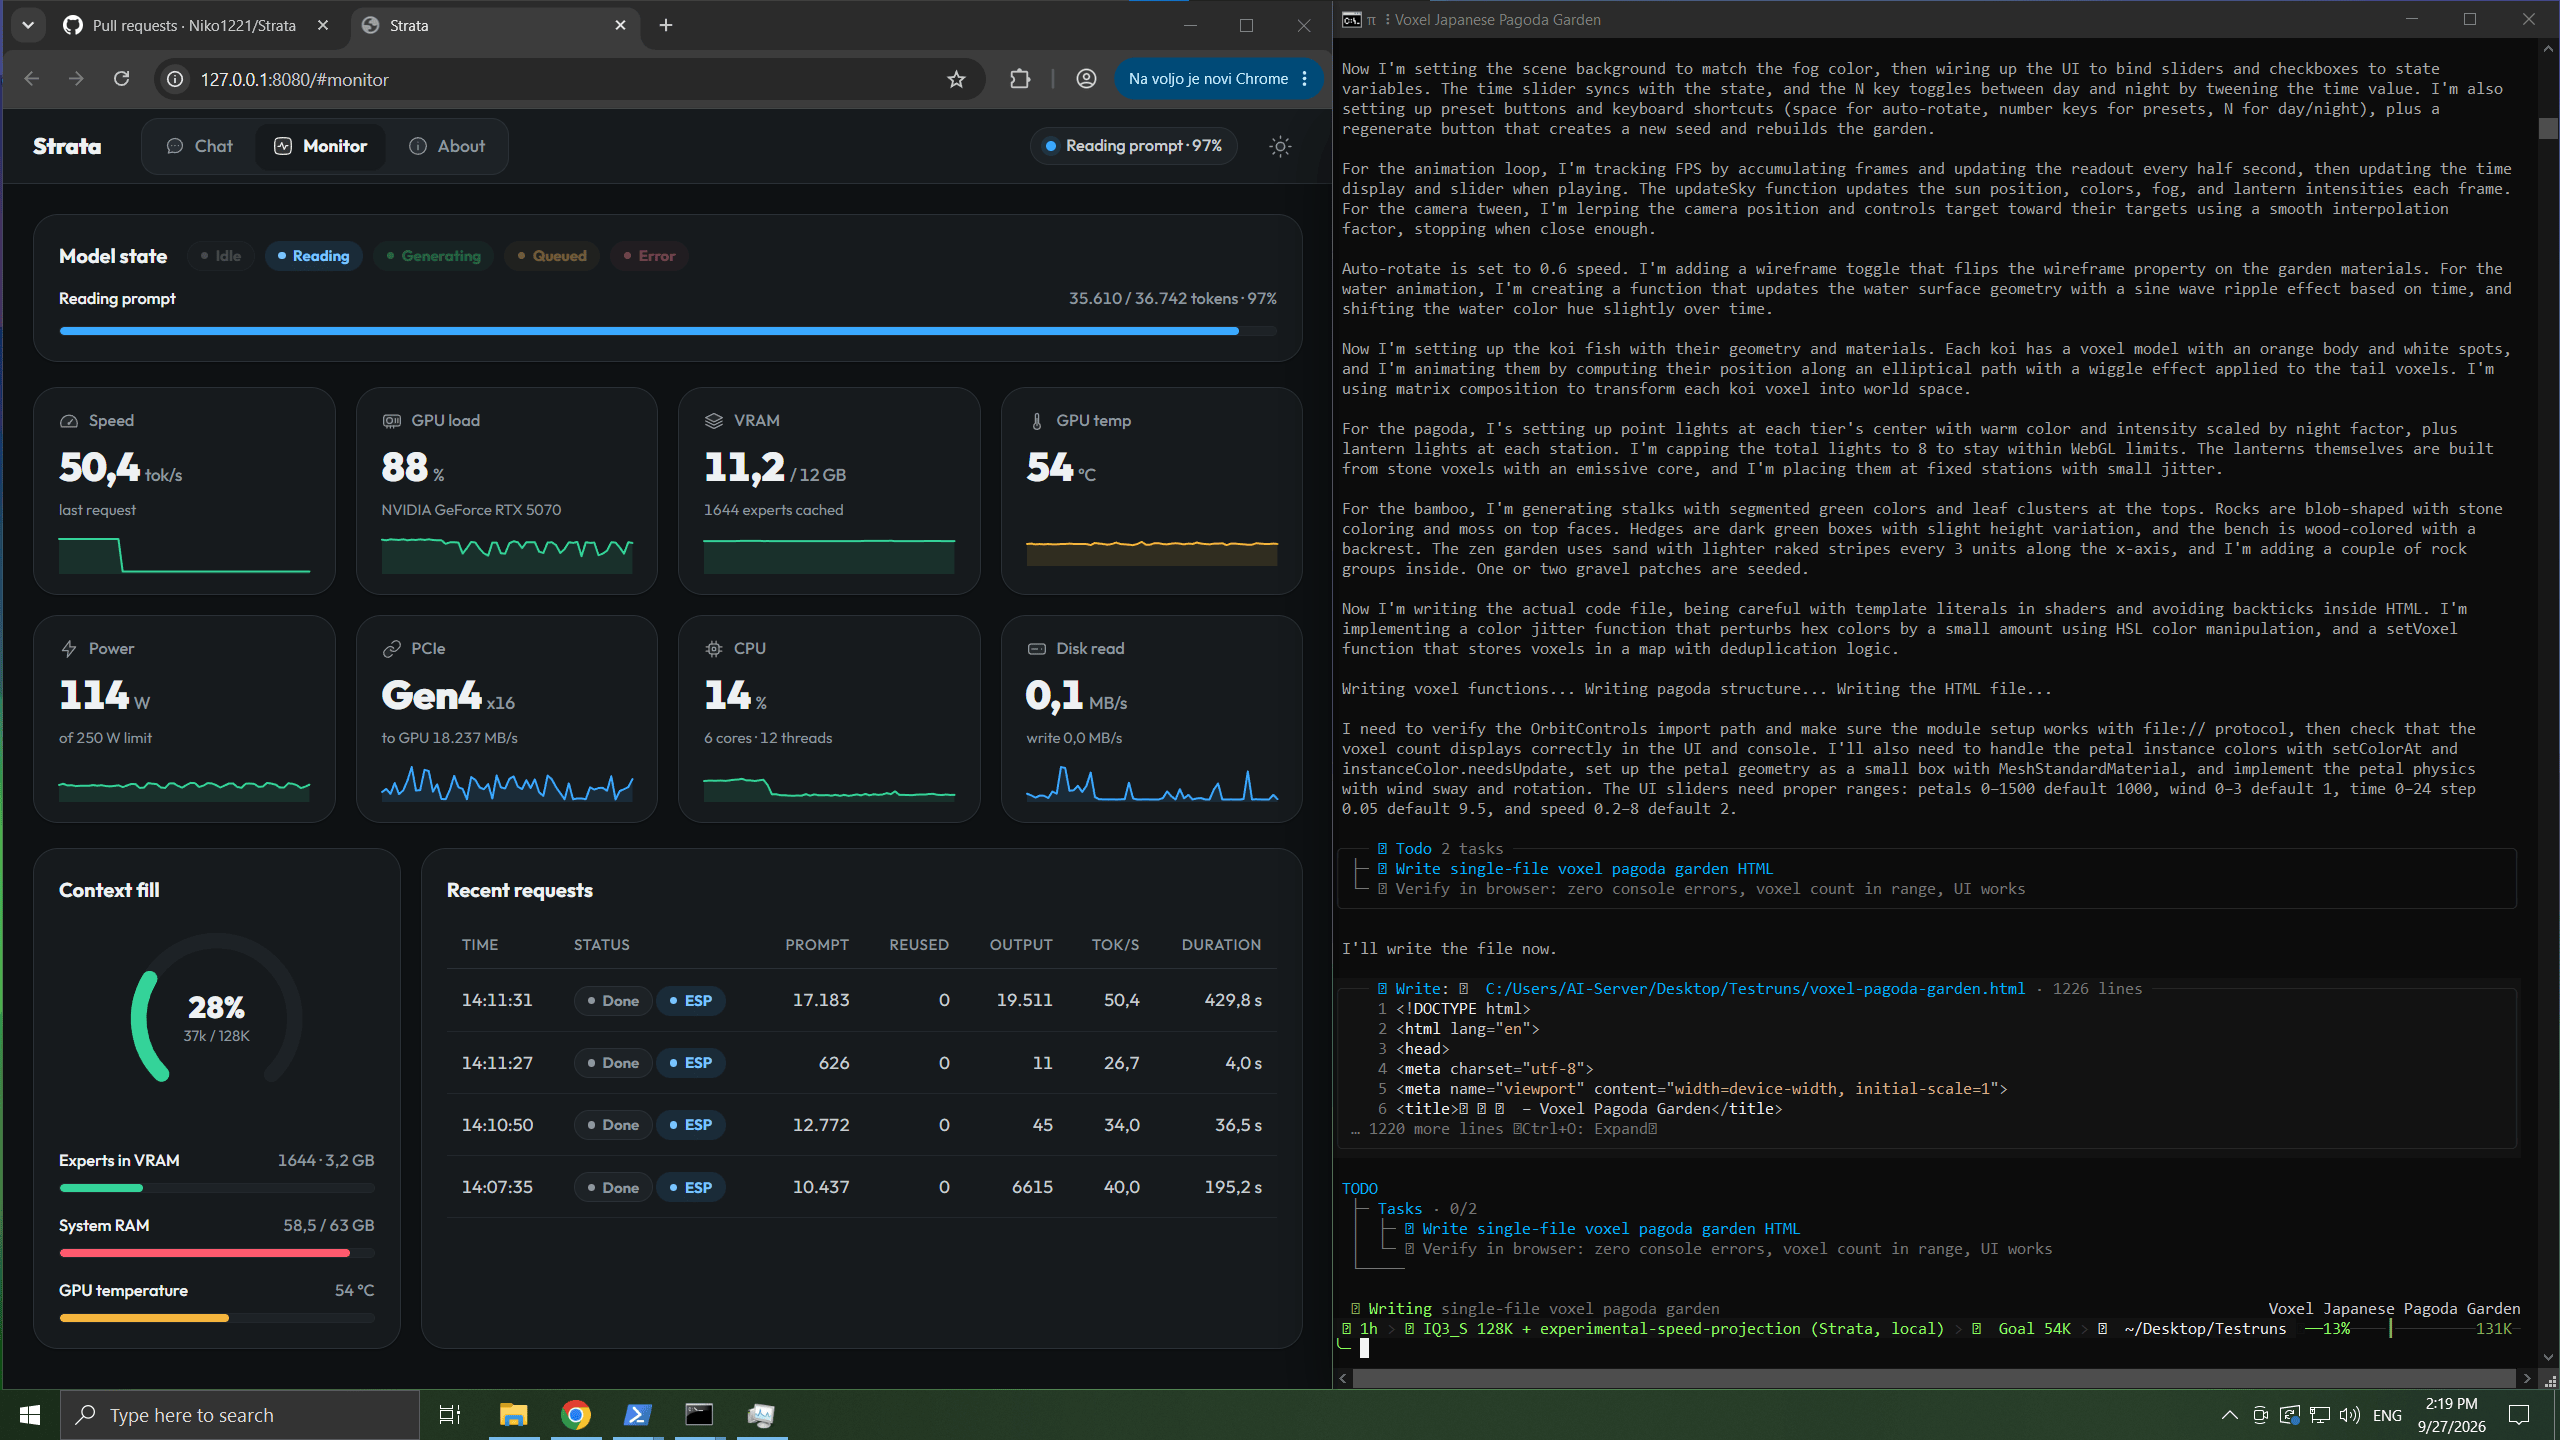
Bagi pengguna agen coding, kompatibilitas API ini bagian paling menarik. Claude Code, Codex CLI, maupun aplikasi lain yang mendukung "OpenAI-compatible provider" cukup diarahkan ke alamat lokal Strata, sehingga tidak ada data yang keluar dari PC.
Perdebatan soal kuantisasi 2-bit dan keamanan installer
Di balik pujian soal kecepatan, komunitas juga ramai membahas sisi kualitas. Inilah beberapa kritik yang paling banyak disukai di Hacker News:
- Kuantisasi terlalu agresif. Beberapa pengguna menegaskan bahwa 4 bit adalah batas bawah yang aman, dan versi Q2_0 yang tercepat adalah versi yang paling banyak dikompresi. Ada juga yang menyindir proyek seperti ini makin mirip "download RAM gratis".
- Belum ada benchmark kualitas resmi. Situs SingularityByte mencatat bahwa semua angka yang dipublikasikan Strata mengukur kecepatan, bukan kualitas jawaban. Satu-satunya klaim kualitas datang dari ISTA-DASLab, yang menyebut IQ3_S setara model penuh pada uji kode yang mereka publikasikan, serta versi Coder yang mencapai 91% skor SWE-bench Verified model penuh.
- Kode banyak dibantu AI. Ada komentar yang menyoroti bahwa README dan sebagian kode tampak ditulis dengan bantuan AI, sehingga perlu diperiksa lebih teliti.
- Instruksi "suruh AI yang memasang". README menyarankan menempelkan perintah ke asisten coding agar asisten tersebut memasang Strata secara otomatis. Sebagian pengguna menilai cara ini lebih berisiko daripada skrip
curl | bashyang sudah sering dikritik.
Di sisi lain, ada juga pengguna yang membela. Beberapa orang mencatat bahwa model besar biasanya lebih tahan terhadap kuantisasi rendah dibanding model kecil, dan beberapa yang sudah memakai IQ3_XXS menyebut hasilnya "sangat bagus" untuk audit keamanan kode PHP maupun tugas coding harian.
Peringatan: Bobot dasar Qwen3.8-Flash-Next memakai lisensi qwen-community-1.0, bukan MIT. Mesin Strata memang MIT, tetapi kalau mau dipakai untuk produk komersial, lisensi modelnya tetap harus dibaca lebih dulu.
Hitungan biaya PC AI lokal di Indonesia
Bagian ini paling relevan buat pembaca di sini. Kabar baiknya, Strata gratis dan tidak butuh langganan dalam dolar. Kabar kurang enaknya, kebutuhan RAM-nya besar di saat harga memori sedang mahal.
Berikut gambaran harga komponen yang dibutuhkan, berdasarkan pantauan toko daring dan media lokal sepanjang 2026:
- RTX 3060 12 GB baru: sekitar Rp6,1–6,3 juta. Ini pintu masuk paling murah ke syarat VRAM 12 GB.
- RTX 5060 Ti 16 GB: mulai sekitar Rp8,2 juta, dengan merek tertentu bisa sampai Rp15–16 jutaan.
- RTX 5070 12 GB: sekitar Rp12,5–19 juta, tergantung merek dan penjual.
- RAM DDR5: harganya sempat melonjak gila-gilaan pada awal 2026. Di ITC Kuningan, DDR5 32 GB sempat dijual Rp7–8 juta pada Februari. Harga global mulai turun sejak April, tetapi di Indonesia penurunannya masih lambat.
- SSD NVMe 1 TB: wajib dipertimbangkan, karena file modelnya sendiri sudah 66–94 GB.
Dari daftar itu, PC gaming yang sudah punya RTX 3060 12 GB atau RTX 4060 Ti 16 GB sebenarnya berada di posisi paling enak. Yang perlu ditambah biasanya hanya RAM. Kalau RAM saat ini 16 GB, minimal perlu naik ke 32 GB untuk versi Coder, atau ke 64 GB untuk versi penuh.
Soal listrik, hitungannya juga masih wajar. Laporan pengguna RTX 4090 mencatat konsumsi GPU sekitar 270–300 watt saat bekerja penuh. Kalau satu PC menghabiskan sekitar 350 watt selama 4 jam per hari, pemakaiannya kira-kira 42 kWh per bulan. Dengan tarif rumah tangga nonsubsidi sekitar Rp1.400-an per kWh, tambahannya sekitar Rp60 ribuan per bulan.
Ada satu alasan lain kenapa topik AI lokal makin relevan. Mulai 9 Oktober 2026, pengguna Gemini gratis hanya akan mendapat model Flash-Lite. Banyak layanan AI juga makin ketat soal kuota. Model lokal seperti ini memberi alternatif tanpa kuota, tanpa kartu kredit, dan tanpa mengirim dokumen kantor ke server luar negeri.
Siapa yang cocok mencoba Strata, dan siapa yang sebaiknya menunggu
Strata bukan untuk semua orang. Berikut gambaran singkatnya:
Cocok untuk:
- Developer yang ingin agen coding lokal tanpa tagihan API, terutama yang sudah punya GPU 12–24 GB.
- Pekerja yang menangani data sensitif, misalnya kontrak, laporan internal, atau data klien yang tidak boleh diunggah ke layanan cloud.
- Pemilik PC gaming dengan RAM 64 GB yang ingin mencoba model kelas atas tanpa membeli hardware baru.
- Mahasiswa dan peneliti yang butuh model besar untuk eksperimen dan tidak mau terikat kuota harian.
Sebaiknya menunggu dulu:
- Pengguna dengan RAM 16 GB atau GPU di bawah 12 GB, karena hasilnya akan lambat atau tidak bisa dijalankan.
- Tim yang butuh banyak permintaan bersamaan, karena Strata didesain untuk satu pengguna.
- Pengguna yang butuh kualitas setara model penuh untuk pekerjaan penting, karena belum ada benchmark kualitas independen untuk versi 2-bit.
- Pengguna yang hanya punya laptop tipis tanpa GPU diskrit. Komunitas memang melaporkan model ini bisa jalan di Ryzen 8845HS dengan RAM 96 GB, tetapi kecepatannya hanya sekitar 7 token/s.
Proyek ini juga bergerak sangat cepat, dengan rilis baru hampir tiap beberapa hari. Bagi yang tidak ingin repot memperbarui, menunggu satu atau dua bulan sampai versinya lebih stabil adalah pilihan yang masuk akal.
Poin penting
- Strata adalah mesin inferensi gratis berlisensi MIT yang menjalankan Qwen3.8-Flash-Next 125B di PC gaming.
- Syarat minimalnya GPU 12 GB, RAM 32 GB, dan SSD sekitar 80 GB, dengan RAM 64 GB sebagai titik ideal.
- Kecepatan resmi di RTX 5070 mencapai 53–94 token/s, tergantung ukuran model.
- Model hanya mengaktifkan 6 miliar parameter per token, itulah alasan model ini bisa dibagi ke VRAM, RAM, dan SSD.
- Kualitas versi 2-bit masih diperdebatkan, dan lisensi bobot model berbeda dengan lisensi mesinnya.
- Di Indonesia, komponen yang paling menentukan biaya justru RAM, bukan kartu grafis.
Referensi
- GitHub (2026). Niko1221/Strata: Qwen3.8-Flash-Next on any consumer hardware
- GitHub (2026). Strata Docs: Which model? Sizes, versions and what fits
- GitHub (2026). Strata Docs: Technical details and speed measured
- Hugging Face (2026). Qwen/Qwen3.8-Flash-Next model card
- Hugging Face (2026). ISTA-DASLab Qwen3.8-Flash-Next GSQ-RCO GGUF
- Hacker News (2026). Run Qwen 3.8 Flash Next (125B) on consumer hardware (RTX 4090) at 100T/s
- Reddit r/LocalLLaMA (2026). Qwen3.8 Flash Next ISTA-DASLab GGUF 50t/s TG and 1500t/s PP with 12GB VRAM laptop on Strata engine
- SingularityByte (2026). Strata: Run a 125B Model on a 12 GB Gaming GPU
- Tools Network Blog (2026). Strata v0.1.39: Qwen3.8-Flash-Next 125B on a 12 GB gaming GPU
- Ferstar Blog (2026). 4090 24G Local Deployment of Qwen3.8-Flash-Next: Switching from Ollama to Strata
- detikInet (2026). Gila! RAM DDR5 64GB Kini Lebih Mahal dari MacBook Air
- Jagat Review (2026). Harga DRAM Mulai Turun, Tapi Masih Tetap Tinggi
- 9to5Google (2026). Gemini app limiting what models free and AI Plus users can access
- BigGo Indonesia (2026). Harga RTX 5070 dan RTX 5060 Ti 16GB Terbaru
Pertanyaan Umum
Apakah Strata gratis?
Berapa spek PC minimal untuk menjalankan Qwen 3.8 Flash Next lewat Strata?
Apakah RTX 3060 12 GB bisa dipakai?
Apakah hasil jawabannya sebagus versi cloud?
Apakah Strata bisa dipakai untuk Claude Code atau Codex CLI?
Apakah Strata bisa jalan di laptop?
Kesimpulan
Strata menunjukkan bahwa model AI kelas 125 miliar parameter tidak lagi harus tinggal di server mahal. Dengan memanfaatkan arsitektur MoE Qwen3.8-Flash-Next yang hanya mengaktifkan 6 miliar parameter per token, proyek ini membagi beban ke VRAM, RAM, dan SSD sehingga PC gaming dengan RTX 12 GB pun bisa menulis jawaban dengan kecepatan 50 sampai 90-an token per detik.
Meski begitu, Strata masih proyek yang sangat muda. Kualitas versi 2-bit masih diperdebatkan, lisensi model perlu dibaca untuk pemakaian komersial, dan kebutuhan RAM-nya cukup berat di tengah harga memori yang masih tinggi di Indonesia. Bagi yang sudah punya GPU 12–16 GB dan RAM 64 GB, Strata layak dicoba sekarang. Bagi yang harus belanja RAM dari nol, memantau perkembangan proyek ini satu atau dua bulan lagi bisa jadi langkah yang lebih bijak.
Komentar (0)
Belum ada komentar. Jadilah yang pertama berbagi pendapat!
Tinggalkan komentar