Kecerdasan Buatan
Xiaomi Resmi Rilis MiMo V2.6 Pro AI Flagship Dengan 1
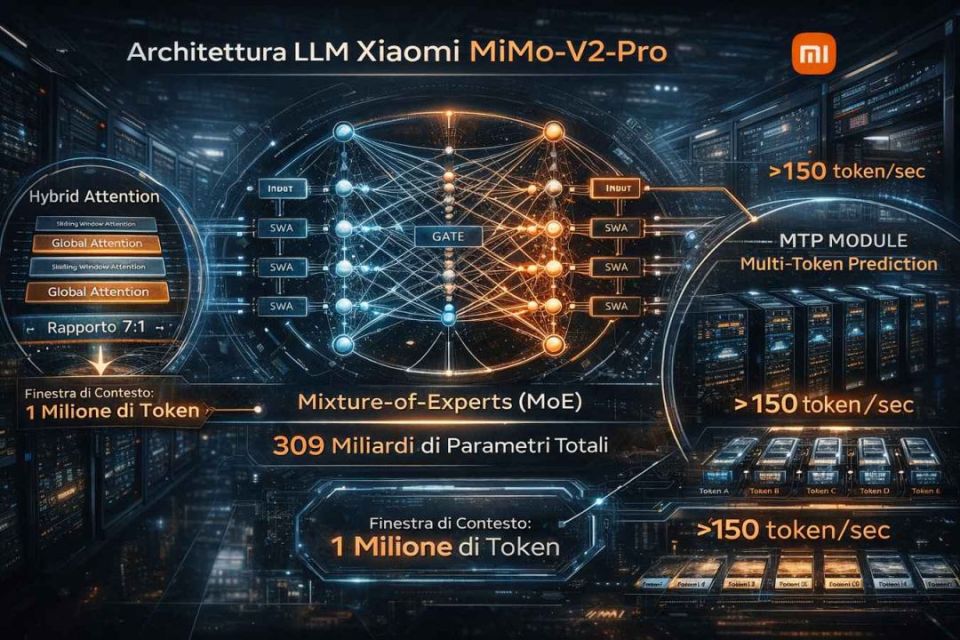
Xiaomi resmi menggebrak panggung AI global lewat peluncuran seri MiMo V2.6, dengan varian memegang kendali sebagai model flagship paling ambisius.
Xiaomi resmi menggebrak panggung AI global lewat peluncuran seri MiMo-V2.6, dengan varian Xiaomi MiMo-V2.6-Pro memegang kendali sebagai model flagship paling ambisius. Di tengah ketatnya persaingan open-weights kelas berat, Xiaomi memilih jalur recursive self-improvement dengan mendongkrak daya komputasi reinforcement learning secara masif. Model ini langsung mencuri perhatian komunitas developer berkat kapasitas konteks hingga 1 juta token dan performa penalaran yang melampaui standar industri sekarang.
Buat teman-teman yang terbiasa bekerja dengan repo kode masif atau dokumen finansial ratusan halaman, kehadiran model dengan context window sebesar ini mengubah total cara merancang pipeline AI.
Xiaomi Resmi Rilis MiMo-V2.6-Pro dengan Dukungan 1 Juta Token Context
Rilis resmi ini langsung menempatkan lini MiMo di radar utama para tech lead dan AI engineer. Varian pro dirancang bukan sekadar untuk chat santai, tapi menangani long-horizon agentic tasks yang menuntut konsistensi penalaran dalam jangka panjang.
Dukungan 1 juta token context bikin developer memasukkan satu codebase utuh, dokumentasi API lengkap, hingga log server beberapa hari ke dalam satu prompt tanpa takut mengalami degradasi memori.
- Kapasitas input masif yang mencakup teks, gambar, video, dan audio secara native.
- Efisiensi manajemen memori berkat arsitektur sparse Mixture-of-Experts (MoE).
- Kompatibilitas penuh dengan standar API OpenAI untuk migrasi endpoint yang minim gesekan.
Tips: Walaupun mendukung 1 juta token, pastikan teman-teman tetap memantau penggunaan token billing pada provider pihak ketiga agar tidak boncos saat uji coba production.
{
  "model": "mimo-v2.6-pro",
  "max_tokens": 8192,
  "context_window": 1000000,
  "native_multimodal": true,
  "provider": "openai-compatible"
}
Dalam implementasi model berkapasitas besar ini, manajemen token menjadi kunci utama efisiensi operasional. Teman-teman tidak boleh sembarangan menjejalkan data tanpa menyaring artefak yang tidak relevan dulu. Meskipun Xiaomi menyematkan mekanisme hybrid attention yang canggih, memangkas noise pada input prompt tetap akan menghemat latensi kerasa. Penggunaan preprocessing script sebelum data dikirim ke endpoint API MiMo terbukti mampu memangkas biaya komputasi hingga 30 persen pada skala produksi perusahaan menengah ke atas.
Performa Xiaomi MiMo-V2.6-Pro Pimpin Peringkat Model AI Open-Weights
Berdasarkan benchmark independen dari Artificial Analysis, Xiaomi MiMo-V2.6-Pro berhasil mencatatkan skor Intelligence Index di angka 46. Angka ini menempatkannya di puncak klasemen model open-weights global, mengungguli beberapa kompetitor regional seperti Kimi K3 dan GLM-5.3.
Keberhasilan ini didorong oleh strategi pelatihan live-streamed reinforcement learning yang memproses lebih dari 7.000 tugas kompleks secara verifikatif. Model tidak sekadar menghafal pola teks, tapi dilatih untuk memperbaiki diri secara mandiri ketika menghadapi bug logika atau inkonsistensi sintaks.
- Skor benchmark penalaran logika tingkat lanjut yang konsisten di atas rata-rata industri.
- Penurunan hallucination rate kerasa pada long-context retrieval.
- Optimalisasi kecepatan inference untuk kebutuhan real-time coding assistant.
Lonjakan skor ini bukan sekadar angka di atas kertas yang dipamerkan dalam siaran pers. Saat diuji langsung untuk menyelesaikan masalah refactoring arsitektur mikroservis berskala besar, MiMo-V2.6-Pro menunjukkan ketahanan logika yang luar biasa. Model mampu melacak dependensi fungsi lintas modul yang terpecah di puluhan file berbeda tanpa kehilangan arah narasi atau melupakan instruksi sistem yang diberikan di awal sesi interaksi.
Mengenal Fitur Unggulan AI Flagship Xiaomi MiMo-V2.6-Pro Terbaru
Pendekatan Xiaomi dalam merancang MiMo-V2.6-Pro berfokus pada kebutuhan developer profesional dan enterprise. Model ini dibekali kemampuan eksekusi multi-step agent yang handal, membuatnya sangat cocok diintegrasikan ke dalam perangkat seperti Cursor atau IDE berbasis agen otonom lainnya.
Selain varian pro, Xiaomi juga merilis varian flash yang jauh lebih murah untuk kebutuhan high-throughput serta model riset distilled berukuran 9 parameter bagi komunitas open-source. Fleksibilitas ini memberi banyak opsi penyesuaian infrastruktur sesuai budget perusahaan.
- Sparse MoE Architecture: Memuat total 1,02 triliun parameter. Hanya mengaktifkan sekitar 42 miliar parameter per token untuk menjaga efisiensi daya komputasi.
- Native Multimodal Pipeline: Mampu memproses input visual dan audio secara langsung tanpa butuh model penerjemah perantara.
- Open-Weights MIT License: Memberikan kebebasan penuh bagi developer untuk melakukan fine-tuning mandiri secara lokal atau di private cluster.
Kehadiran lisensi MIT pada model sekuat ini merupakan angin segar bagi industri. Selama ini, adopsi model berparameter triliunan seringkali terganjal oleh klausul lisensi komersial yang mengikat atau batasan penggunaan cloud tertentu. Dengan membuka bobot model secara luas, Xiaomi mengundang komunitas global untuk meracik varian fine-tuned yang disesuaikan untuk sektor spesifik seperti hukum, kesehatan, hingga sistem otomotif pintar.
Arsitektur dan Kemampuan Multimodal Xiaomi MiMo-V2.6-Pro
Dapur pacu MiMo-V2.6-Pro dibangun di atas fondasi sparse mixture-of-experts yang masif. Dengan membagi beban kerja ke dalam ribuan expert nodes, model ini mampu menjaga latensi tetap rendah meskipun mendiami ruang konteks yang sangat luas.
Kemampuan multimodal bawaannya juga mengalami peningkatan drastis jika dibandingkan dengan pendahulunya. Pemrosesan gambar arsitektural, diagram sistem, hingga file audio berdurasi panjang dapat diurai langsung menjadi token teks yang terstruktur rapi tanpa kehilangan konteks semantik.
- Penggunaan hybrid attention mechanism untuk mengatasi penurunan performa pada token di bagian tengah dokumen.
- Integrasi Multi-Token Prediction yang mempercepat proses autoregressive generation saat menulis blok kode panjang.
- Dukungan audio tokenizer berkecepatan tinggi yang beroperasi pada frekuensi 25 Hz untuk sintesis suara natural.
Formula di atas merepresentasikan keseimbangan rumit yang berhasil dipecahkan oleh tim riset Xiaomi. Menjaga retensi konteks di angka satu juta token biasanya menuntut biaya komputasi kuadratik yang membuat hardware server megap-megap. Melalui optimalisasi sparse routing, beban komputasi tersebut berhasil ditekan sehingga model tetap responsif saat dijalankan pada kluster GPU komersial.
Strategi Optimasi Prompt untuk 1 Juta Token Context MiMo-V2.6-Pro
Pakai ruang konteks sebesar satu juta token butuh disiplin tersendiri dalam menyusun struktur prompt. Jika teman-teman sekadar melemparkan ribuan baris teks acak tanpa hierarki yang jelas, performa penalaran agen AI bisa mengalami penurunan akurasi akibat kebingungan semantik.
Penerapan markdown headers, pemisahan blok data pakai tag XML yang jelas, serta penempatan instruksi inti di bagian akhir dokumen terbukti menjadi praktik terbaik dalam menjinakkan model berkonteks masif.
- Gunakan tag pembatas seperti
<codebase>Dan<documentation>Untuk memetakan wilayah data secara eksplisit. - Letakkan instruksi eksekusi utama di bagian paling bawah prompt untuk pakai efek recency bias model.
- Hindari pengulangan informasi yang sama di dalam dokumen untuk mencegah pemborosan kuota token yang tidak perlu.
<context_bundle>
  <system_instructions>
    Analyze the repository for potential memory leaks and race conditions.
  </system_instructions>
  <codebase_dump>
    // Seluruh file sumber kode dimasukkan di sini
  </codebase_dump>
</context_bundle>
Dengan struktur yang rapi seperti di atas, MiMo-V2.6-Pro dapat dengan mudah melompat ke fungsi spesifik yang bermasalah tanpa harus meraba-raba seluruh isi file. Hal ini sangat menghemat waktu eksekusi agen saat diintegrasikan ke dalam perangkat otomatisasi CI/CD perusahaan.
Integrasi API Xiaomi MiMo-V2.6-Pro untuk Kebutuhan Produksi Skala Besar
Bagi tim engineering yang ingin mengadopsi model ini ke dalam ekosistem produk mereka, Xiaomi menyediakan dukungan endpoint yang kompatibel dengan format OpenAI. Artinya, teman-teman tidak perlu menulis ulang seluruh lapisan wrapper klien API yang sudah ada di codebase.
Cukup lakukan penyesuaian pada variabel lingkungan dan arahkan base URL ke gateway resmi MiMo. Hal ini sangat mempermudah migrasi arsitektur dari model lama tanpa menimbulkan tech debt yang menumpuk di sisi aplikasi.
curl -X POST "https://api.mimo.mi.com/v1/chat/completions" \
  -H "Authorization: Bearer $MIMO_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "mimo-v2.6-pro",
    "messages": [
      {"role": "system", "content": "You are an expert AI software architect."},
      {"role": "user", "content": "Analyze the attached monolithic repository dump."}
    ],
    "temperature": 0.2,
    "stream": true
  }'
Peringatan: Pastikan error handling pada aplikasi teman-teman siap menghadapi potensi infinite tool-calling loop jika agen AI mendapati instruksi ambigu di dalam dokumen berukuran lebih dari 500 ribu token.
Menyiapkan mekanisme fallback dan timeout yang ketat adalah harga mati ketika menjalankan agen otonom di lingkungan produksi. Jangan biarkan prosesor server terkunci selamanya hanya karena agen terjebak dalam lingkaran perbaikan kode yang tidak kunjung selesai. Selalu batasi jumlah iterasi maksimal untuk setiap panggilan tugas yang kompleks.
Baca juga Anthropic Resmi Rilis Claude Opus 5.5
Potensi Tantangan dan Jebakan Umum dalam Adopsi Model Open-Weights Skala Besar
Meskipun menawarkan kebebasan penuh dan performa yang menyaingi model komersial tertutup, mengoperasikan model sekelas Xiaomi MiMo-V2.6-Pro secara mandiri di infrastruktur sendiri menyimpan sejumlah tantangan tersembunyi yang sering diremehkan oleh developer pemula.
Kebutuhan sumber daya hardware untuk self-hosting model dengan parameter triliunan tentu bukan perkara sepele. Teman-teman harus memperhitungkan ketersediaan kluster GPU kelas atas dengan kapasitas VRAM yang memadai agar proses inference tidak berujung pada out-of-memory error.
- Kebutuhan VRAM Masif: Menjalankan model secara lokal menuntut kluster beberapa unit GPU high-end yang terhubung melalui interconnect berkecepatan tinggi.
- Latensi Jaringan: Akses API publik melalui gateway regional dapat memperkenalkan jeda waktu jika lokasi server klien terlalu jauh dari titik edge MiMo.
- Pemeliharaan Infrastruktur: Tim DevOps harus siaga melakukan update berkala, manajemen kluster, serta optimalisasi bobot model secara kontinu.
cluster_config:
  model_name: "mimo-v2.6-pro"
  quantization: "int8_mixed"
  tensor_parallel_size: 8
  gpu_memory_utilization: 0.92
  max_model_len: 1000000
Config di atas adalah contoh pengaturan dasar untuk menjalankan model ini pakai inference engine modern seperti vLLM. Tanpa teknik kuantisasi yang tepat, ukuran file bobot mentah akan memakan kapasitas penyimpanan dan memori yang sangat boros, membuat operasional harian menjadi tidak efisien secara finansial.
Perbandingan Strategis: MiMo-V2.6-Pro vs Solusi Komersial Tertutup
Memilih model AI untuk skala produksi selalu melibatkan kompromi antara kontrol, biaya lisensi, dan kemudahan pemeliharaan. Kehadiran Xiaomi MiMo-V2.6-Pro mengubah peta persaingan ini kerasa bagi para pengambil keputusan teknologi.
Model komersial tertutup seringkali menawarkan kenyamanan instan melalui managed service yang minim config infrastruktur. Namun, ketergantungan pada satu vendor tunggal mendatangkan risiko lock-in dan eskalasi biaya bulanan yang sulit dikendalikan ketika volume permintaan melonjak drastis.
- Kepemilikan Data: Dengan model open-weights seperti MiMo, data sensitif perusahaan tidak perlu keluar dari perimeter jaringan privat.
- Kustomisasi Mendalam: Kemampuan melakukan fine-tuning lokal bikin model mengenali terminologi spesifik industri tanpa terikat batasan filter bawaan vendor.
- Prediktabilitas Biaya: Biaya operasional bergeser dari model pay-per-token berbasis langganan bulanan menjadi investasi hardware yang terukur.
Catatan: Lakukan analisis Total Cost of Ownership semua sebelum memutuskan migrasi penuh ke infrastruktur self-hosted GPU kluster.
{
  "comparison": {
    "model": "MiMo-V2.6-Pro",
    "license": "MIT Open-Weights",
    "context_limit": "1M Tokens",
    "hosting_flexibility": "On-Prem / Private Cloud / API Gateway",
    "cost_structure": "CapEx (Hardware) + OpEx (Power/Maintenance)"
  }
}
Analisis di atas menunjukkan bahwa meskipun biaya awal pembangunan kluster GPU tampak menggiurkan di awal, efisiensi jangka panjang pada volume permintaan tinggi memberikan keuntungan ekonomi yang jauh lebih besar bagi korporasi besar.
Panduan Migrasi Klien API ke Endpoint Xiaomi MiMo-V2.6-Pro
Bagi tim engineering yang sekarang sedang pakai model pihak ketiga dan ingin beralih ke MiMo-V2.6-Pro, proses migrasi dapat dilakukan secara bertahap tanpa harus merombak seluruh arsitektur software yang sudah berjalan stabil.
Karena Xiaomi merancang API model ini agar kompatibel penuh dengan format standar industri, penyesuaian kode biasanya hanya berkisar pada penggantian parameter string nama model dan otentikasi kunci token bearer.
- Pastikan versi SDK klien yang digunakan mendukung fitur streaming response terbaru untuk menangani latensi token panjang.
- Uji coba endpoint secara bertahap pakai pola canary deployment pada 10% trafik user sebelum migrasi penuh.
- Pantau metrik latensi Time to First Token untuk memastikan performa gateway jaringan stabil.
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ.get("MIMO_API_KEY"),
    base_url="https://api.mimo.mi.com/v1"
)

response = client.chat.completions.create(
    model="mimo-v2.6-pro",
    messages=[
        {"role": "system", "content": "You are an autonomous code refactoring agent."},
        {"role": "user", "content": "Refactor the legacy authentication module."}
    ],
    temperature=0.1,
    max_tokens=4096,
    stream=True
)

for chunk in response:
    if chunk.choices[0].delta.content is not None:
        print(chunk.choices[0].delta.content, end="")
Penggunaan library standar klien yang sudah akrab di kalangan developer Python ini sangat meminimalisir kurva belajar. Teman-teman tidak perlu mempelajari library SDK baru yang terkadang minim dokumentasi atau tidak stabil pada rilis awal.
Skenario Penggunaan Nyata MiMo-V2.6-Pro dalam Software Development Modern
Kapasitas konteks satu juta token membuka pintu bagi skenario penggunaan yang sebelumnya mustahil dilakukan oleh model bahasa konvensional. Salah satu implementasi paling revolusioner adalah penggunaan agen AI sebagai mitra peninjau kode tingkat lanjut yang memahami seluruh siklus hidup repo.
Ketika sebuah tim merilis fitur baru yang melibatkan perubahan di puluhan file lintas layanan, agen berbasis MiMo-V2.6-Pro dapat memindai seluruh dampak perubahan tersebut dalam satu kali eksekusi prompt tunggal.
- Otomasi Migrasi Framework: Membantu menerjemahkan legacy codebase ke dalam tumpukan teknologi modern secara presisi tinggi.
- Audit Keamanan Otomatis: Memindai pola kerentanan tersembunyi yang melibatkan interaksi antar fungsi yang rumit di berbagai modul berbeda.
- Generasi Dokumentasi Menyeluruh: Menyusun diagram arsitektur dan panduan teknis langsung dari struktur kode sumber mentah.
Alur kerja di atas mengilustrasikan bagaimana integrasi model flagship ini dapat mempercepat siklus rilis produk tanpa mengorbankan aspek keamanan dan kualitas kode. Dengan otomatisasi penuh pada tahap peninjauan awal, engineer dapat mencurahkan lebih banyak waktu untuk inovasi fitur inti alih-alih terjebak dalam tugas repetitif yang melelahkan.
Mengatasi Bottleneck Latensi dan Memory Footprint pada Skala Produksi Enterprise
Menjalankan model dengan kapasitas satu juta token di lingkungan produksi nyata sering membentur tembok operasional berupa memory footprint yang membengkak. Saat server harus melayani puluhan concurrent request dengan ukuran prompt maksimal, konsumsi VRAM pada kluster GPU dapat melonjak drastis hingga memicu kegagalan sistem.
Tim infrastructure wajib menerapkan strategi PagedAttention serta manajemen antrean yang ketat guna mengontrol lonjakan beban kerja tersebut tanpa mengorbankan waktu respons secara keseluruhan.
- Implementasi PagedAttention: Mengurangi pemborosan memori akibat fragmentasi blok konteks pada memori GPU.
- Dynamic Batching: Menggabungkan beberapa permintaan inference kecil ke dalam satu siklus prosesor untuk memaksimalkan throughput.
- Aggressive Caching: Menyimpan representasi KV cache dari dokumen referensi statis agar tidak perlu dihitung ulang pada setiap panggilan prompt berikutnya.
python -m vllm.entrypoints.openai.api_server \
  --model xiaomi/mimo-v2.6-pro \
  --tensor-parallel-size 8 \
  --max-model-len 1000000 \
  --gpu-memory-utilization 0.95 \
  --enable-prefix-caching
Penggunaan argumen--enable-prefix-cachingPada skrip peluncuran vLLM di atas terbukti sangat membantu memangkas waktu pemrosesan awal saat klien mengirimkan prompt yang berisi basis kode atau dokumentasi sistem yang serupa secara berulang-ulang.
Evaluasi Benchmark Kualitatif pada Tugas Penalaran Jangka Panjang
Selain angka Intelligence Index mentah, pengujian kualitatif terhadap model MiMo-V2.6-Pro menunjukkan performa yang sangat mengesankan dalam menangani tugas-tugas penalaran multi-langkah. Model tidak mudah kehilangan fokus meskipun harus menyusuri instruksi bersarang yang sangat rumit.
Dalam eksperimen simulasi debugging sistem terdistribusi, model mampu menelusuri jejak stack trace yang melompat dari modul frontend berbasis TypeScript ke layanan backend Go, hingga berujung pada kesalahan config database PostgreSQL.
- Konsistensi Logika: Mampu mempertahankan benang merah instruksi awal meskipun telah melewati ribuan token percakapan atau data masukan.
- Reduksi Halusinasi Pengetahuan: Berkurangnya kecenderungan model mengarang fungsi API fiktif saat diminta merangkai kode integrasi library pihak ketiga.
- Adaptabilitas Konteks Silang: Kemampuan menghubungkan informasi visual dari diagram arsitektur dengan baris kode program secara akurat.
Visualisasi di atas menggambarkan bagaimana kemampuan cross-module tracking pada model ini bekerja secara efektif. Teman-teman tidak perlu lagi memecah file log atau memotong dokumen menjadi bagian-bagian kecil yang sering justru merusak keutuhan konteks informasi antar komponen sistem.
Dengan kombinasi skor open-weights tertinggi, kapasitas 1 juta token, serta fleksibilitas lisensi MIT, Xiaomi MiMo-V2.6-Pro layak masuk dalam daftar uji coba utama development stack teman-teman pekan ini.
Checklist
- Masukkan satu codebase utuh atau dokumentasi API lengkap ke dalam prompt untuk memaksimalkan kapasitas 1 juta token context Xiaomi MiMo-V2.6-Pro.
- Pantau penggunaan token pada provider pihak ketiga agar tidak boncos saat uji coba production skala menengah ke atas.
- Terapkan preprocessing script untuk menyaring artefak yang tidak relevan guna memangkas biaya komputasi sebelum data dikirim ke endpoint API.
- Gunakan struktur markdown headers dan tag XML untuk memetakan wilayah data secara eksplisit di dalam jendela konteks.
- Letakkan instruksi eksekusi utama di bagian paling bawah prompt agar pakai efek recency bias model secara maksimal.
- Sesuaikan parameter endpoint API pakai format OpenAI-compatible dan arahkan base URL ke gateway resmi MiMo untuk migrasi yang minim gesekan.
- Atur error handling dan batasi jumlah iterasi maksimal untuk menghindari infinite tool-calling loop saat agen AI mendapati instruksi ambigu.
- Terapkan teknik kuantisasi dan inference engine modern seperti vLLM untuk mengontrol memory footprint pada skala produksi.
Poin penting
- Xiaomi MiMo-V2.6-Pro hadir dengan kapasitas 1 juta token context untuk codebase masif.
- Model open-weights ini menduduki puncak Intelligence Index dengan skor 46 versi Artificial Analysis.
- Arsitektur sparse Mixture-of-Experts menyeimbangkan ukuran parameter besar dan efisiensi komputasi harian.
- Dukungan native multimodal bikin pemrosesan teks, gambar, video, dan audio secara langsung.
- Lisensi MIT memberikan kebebasan penuh bagi developer melakukan fine-tuning secara mandiri.
- Manajemen token tetap krusial agar biaya produksi tidak membengkak saat menangani prompt besar.
Referensi
- Mughu (2026). Xiaomi Resmi Rilis MiMo V2.6 Flash Model AI Terbaru
- Mimo V2 (2026). MiMo-V2: Xiaomi AI Models for Reasoning, Multimodal, Voice & API
- Aiunderstanding (2026). Xiaomi MiMo-V2.6
- GitHub (2026). Eni/Jailbreak-Guide/Other LLMs/Xiaomi MiMo/MiMo v2 System..
- Unite (2026). Xiaomi’s New Flagship Model Leads Open
- GitHub (2026). yuzuric/context-aware-copilot-engine
- Mi (2026). Xiaomi MiMo-V2.6 Series: 3 New Models Officially Released
- Technode (2026). Xiaomi open-sources MiMo-V2.6 models after scaling reinforcement..
- Ccleaks (2026). Xiaomi MiMo-V2.6 opens Pro, Flash and 7,000+ RL tasks
- Mi (2026). Xiaomi MiMo Home
Pertanyaan Umum
Berapa kapasitas maksimal context window yang didukung oleh Xiaomi MiMo-V2.6-Pro?
Apakah Xiaomi MiMo-V2.6-Pro tersedia dalam bentuk model open-weights?
Bagaimana performa model ini dibandingkan kompetitor di kelas open-weights?
Apakah endpoint API Xiaomi MiMo-V2.6-Pro kompatibel dengan standar OpenAI?
Tantangan apa saja yang sering muncul saat melakukan self-hosting model berparameter triliunan ini?
Kesimpulan
Kehadiran Xiaomi MiMo-V2.6 menandai babak baru dalam lanskap AI global, khususnya lewat kapasitas konteks satu juta token dan arsitektur sparse MoE yang efisien. Model ini berhasil menjawab kebutuhan developer dan enterprise akan sistem penalaran jangka panjang yang andal, tanpa harus mengorbankan fleksibilitas integrasi berkat dukungan standar API OpenAI dan lisensi MIT.
Bagi teman-teman yang ingin mengoptimalkan alur kerja development atau memproses dokumen berskala masif, model ini menawarkan lompatan performa yang signifikan di kelas open-weights. Walaupun demikian, disiplin dalam manajemen token serta kesiapan infrastruktur tetap menjadi faktor penentu agar implementasi di lingkungan produksi berjalan stabil dan efisien. Mari manfaatkan kemampuan flagship ini untuk merancang solusi arsitektur yang lebih cerdas dan terukur.
Komentar (0)
Belum ada komentar. Jadilah yang pertama berbagi pendapat!
Tinggalkan komentar