Kecerdasan Buatan
Nemotron 3.5 Super VL Resmi Rilis, AI NVIDIA Gratis yang Bisa Baca Gambar dan Video
NVIDIA merilis Nemotron 3.5 Super VL pada 15 Oktober 2026. Model terbuka 120B ini bisa membaca gambar, PDF, dan video dengan konteks 1 juta token. Ini spek, har
NVIDIA resmi merilis Nemotron 3.5 Super VL pada 15 Oktober 2026. Ini adalah model AI terbuka (open weights) berukuran 120 miliar parameter yang bukan cuma bisa membaca teks, tapi juga gambar, PDF, halaman web, sampai video. Bobot modelnya bisa diunduh gratis, dan versi hosted-nya sudah tersedia di OpenRouter, termasuk varian tanpa biaya.
Artikel ini akan menjelaskan spek lengkap Nemotron 3.5 Super VL, apa yang membuatnya berbeda dari model NVIDIA sebelumnya, berapa harga API-nya kalau dihitung dalam Rupiah, perbedaannya dengan model terbuka lain yang rilis di minggu yang sama, serta catatan praktis buat yang mau mencobanya dari Indonesia.
Apa yang baru di Nemotron 3.5 Super VL
Nama "VL" di belakangnya berarti vision-language. Versi Super sebelumnya hanya mengolah teks, sedangkan versi 3.5 ini sudah dipasangi encoder penglihatan sehingga satu model bisa menangani teks dan visual sekaligus.
Menurut blog resmi NVIDIA, ada beberapa hal utama yang ditawarkan:
- Bisa membaca dokumen visual. Model ini dilatih untuk OCR, membaca tabel, grafik, dan data terstruktur di dalam PDF atau tangkapan layar halaman web.
- Paham video. Input bisa berupa teks, gambar, dan video, sementara output-nya berupa teks.
- Dibuat untuk agen AI. Fokusnya adalah tugas berlapis seperti mengikuti instruksi, memanggil tool, dan menjalankan alur kerja bisnis yang panjang.
- Terbuka penuh. NVIDIA merilis bobot model, dataset, resep training, dan lingkungan reinforcement learning di NeMo Gym.
Keuntungan menggabungkan teks dan visual dalam satu model cukup terasa buat yang membangun agen. Sebelumnya, developer sering harus memakai dua model terpisah, satu untuk membaca gambar dan satu lagi untuk berpikir, lalu mengoper konteks di antara keduanya. Dengan Super VL, konteks itu tetap berada di satu tempat.
Catatan: NVIDIA juga merilis Nemotron 3.5 Bolt 74B di hari yang sama untuk laptop RTX Spark, dan Bolt E4B 4GB dijadwalkan menyusul pada 23 Oktober. Bolt sudah kami bahas terpisah di artikel spek Nemotron Bolt 74B.
Spek lengkap Nemotron 3.5 Super VL
Berikut ringkasan spek resmi berdasarkan model card di Hugging Face dan NVIDIA NIM:
| Komponen | Detail |
|---|---|
| Total parameter | 120B |
| Parameter aktif per token | 12B |
| Arsitektur | Hybrid Mamba-2 + Transformer, Mixture of Experts (512 expert per lapisan MoE) |
| Encoder visual | C-RADIO |
| Panjang konteks | Hingga 1 juta token |
| Input / output | Teks, gambar, video / teks |
| Presisi | BF16 dan NVFP4 |
| Mode berpikir | Bisa dinyalakan atau dimatikan (enable_thinking) |
| Speculative decoding | Bawaan lewat Multi-Token Prediction (MTP) |
| Lisensi | OpenMDW-1.1 |
Angka 120B total tapi 12B aktif ini penting dipahami. Model punya banyak "ahli" kecil di dalamnya, tapi untuk setiap token hanya sebagian kecil yang bekerja. Hasilnya, kemampuan model terasa seperti model besar, sementara biaya hitungnya mendekati model 12B.
Dari sisi training, NVIDIA menyebut model ini dilatih dengan sekitar 26 triliun token, lalu dipoles lagi dengan kira-kira 3,8 juta sampel post-training plus reinforcement learning di puluhan lingkungan.
Untuk video, model card memberi panduan yang cukup jelas:
- Setiap request contoh berisi satu gambar dan satu video.
- Video diambil hingga 256 frame pada 2 FPS.
- Untuk video 1080p, disarankan 1 FPS dengan maksimal 128 frame.
- NVIDIA menyarankan mulai dari klip MP4 pendek berdurasi 1–2 menit.

Seberapa kencang dan seberapa pintar
Klaim terbesar NVIDIA adalah soal kecepatan. Super VL disebut sebagai model agen terbuka tercepat di kelasnya, dengan throughput hingga 5 kali lebih tinggi dibanding pesaing terdekat di ukuran yang sama, mengacu pada leaderboard Artificial Analysis.
Laporan teknis NVIDIA juga memuat beberapa angka menarik:
- SWE-bench Pro 51,78%, lebih tinggi dari Nemotron 3 Ultra padahal parameter aktifnya sekitar 4,6 kali lebih sedikit.
- Hingga 4.856 token output per detik per GPU di GB200, dengan kecepatan minimal 50 token per detik untuk tiap pengguna.
- Versi NVFP4 mempertahankan 99,62% akurasi median versi BF16, sambil memberi throughput 2,43 kali lebih tinggi.
- Jika dijalankan dengan NVIDIA Dynamo, NVIDIA mengklaim bisa melayani hingga 8 kali lebih banyak pengguna dengan latensi 85% lebih rendah.
Soal kepintaran, Pavlo Molchanov dari tim riset NVIDIA menulis di X bahwa skor Artificial Analysis Intelligence Index naik dua kali lipat, dari 13 ke 26, tanpa mengubah arsitektur dibanding Super versi sebelumnya. Kenaikan itu datang dari resep training baru.
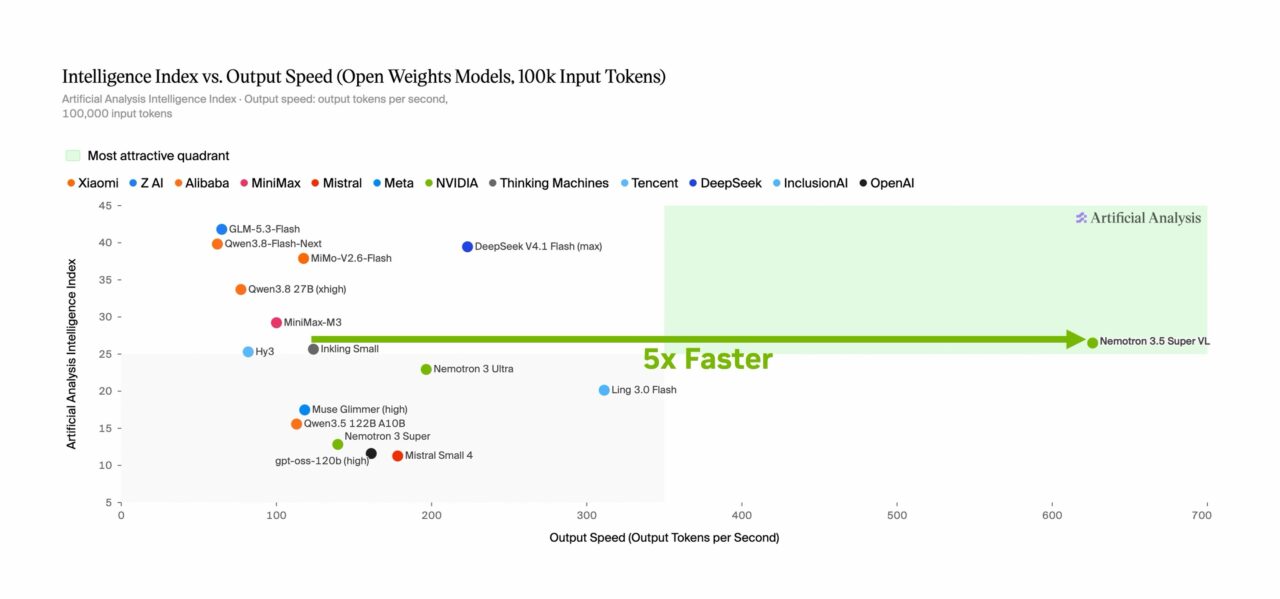
Perlu dicatat juga bahwa semua angka di atas berasal dari NVIDIA dan mitranya. Pengujian independen yang lebih luas biasanya baru muncul beberapa minggu setelah rilis.
Harga API dan cara coba gratis
Kabar baiknya, Nemotron 3.5 Super VL bisa dicoba tanpa harus punya GPU mahal. Model ini sudah tersedia di Hugging Face, ModelScope, OpenRouter, dan NVIDIA NIM. Beberapa pengguna di X juga melaporkan model ini sudah bisa dipakai lewat SageMaker JumpStart di AWS.
Di OpenRouter, ada dua pilihan:
- Varian gratis (
nvidia/nemotron-3.5-super-vl:free) dengan konteks sekitar 1 juta token. Biasanya varian gratis punya batas pemakaian yang lebih ketat. - Varian berbayar (
nvidia/nemotron-3.5-super-vl) dengan harga US$0,10 per 1 juta token input dan US$0,40 per 1 juta token output, plus cache read US$0,08 per 1 juta token.
Kalau dihitung dengan kurs sekitar Rp17.949 per dolar, harganya kira-kira:
| Jenis token | Harga per 1 juta token | Kira-kira dalam Rupiah |
|---|---|---|
| Input | US$0,10 | Rp1.795 |
| Output | US$0,40 | Rp7.180 |
| Cache read | US$0,08 | Rp1.436 |
Harga ini termasuk sangat murah untuk model sebesar 120B. Sebagai gambaran, membaca dokumen PDF setebal 100 halaman dan menulis ringkasan 2.000 kata biasanya hanya menghabiskan beberapa ratus Rupiah.
Buat yang ingin langsung mencoba lewat API, contoh request ke OpenRouter kurang lebih seperti ini:
Baca juga Ask Maps Indonesia: Cara Bikin Itinerary Liburan di Google Maps
curl https://openrouter.ai/api/v1/chat/completions \
  -H "Authorization: Bearer $OPENROUTER_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "nvidia/nemotron-3.5-super-vl:free",
    "messages": [{
      "role": "user",
      "content": [
        {"type": "text", "text": "Ringkas isi tabel di gambar ini dalam bahasa Indonesia."},
        {"type": "image_url", "image_url": {"url": "https://contoh.com/tabel.png"}}
      ]
    }]
  }'
Tips: Mulailah dari varian gratis untuk menguji apakah hasilnya cocok, lalu pindah ke varian berbayar kalau butuh limit yang lebih longgar.
Bisa jalan di komputer sendiri?
Bisa, tapi butuh mesin yang cukup besar. Versi BF16 penuh direkomendasikan berjalan di 4× H100 atau 2× GB200, jadi jelas bukan untuk PC rumahan. Secara kasar, 120 miliar parameter dalam BF16 memakan sekitar 240GB hanya untuk bobot modelnya.
Versi NVFP4 jauh lebih ringan dan sudah dicoba komunitas di mesin desktop. Beberapa hasil yang dibagikan di X:
- Eduardo Dias (@edurdias) menjalankan NVFP4 di satu chip GB10 (yang dipakai DGX Spark) dengan kecepatan 43 token per detik untuk satu pengguna dan 71 token per detik untuk empat pengguna, serta skor GSM8K 97,2%.
- @cg_ftLab dari Jepang memakainya di DGX Spark lewat LM Studio untuk agen OpenClaw. Kecepatannya sekitar 21–25 token per detik. Menurutnya, model ini tidak lebih cepat dari Qwen 3.6 35B yang ia pakai sebelumnya, tapi jawabannya terasa lebih bisa diandalkan.
- Stephen J Ronan (@SJRonanMD) menjalankannya di DGX Station dengan vLLM dan mendapat 539 token per detik untuk satu pengguna, serta 6.199 token per detik saat melayani 128 pengguna.
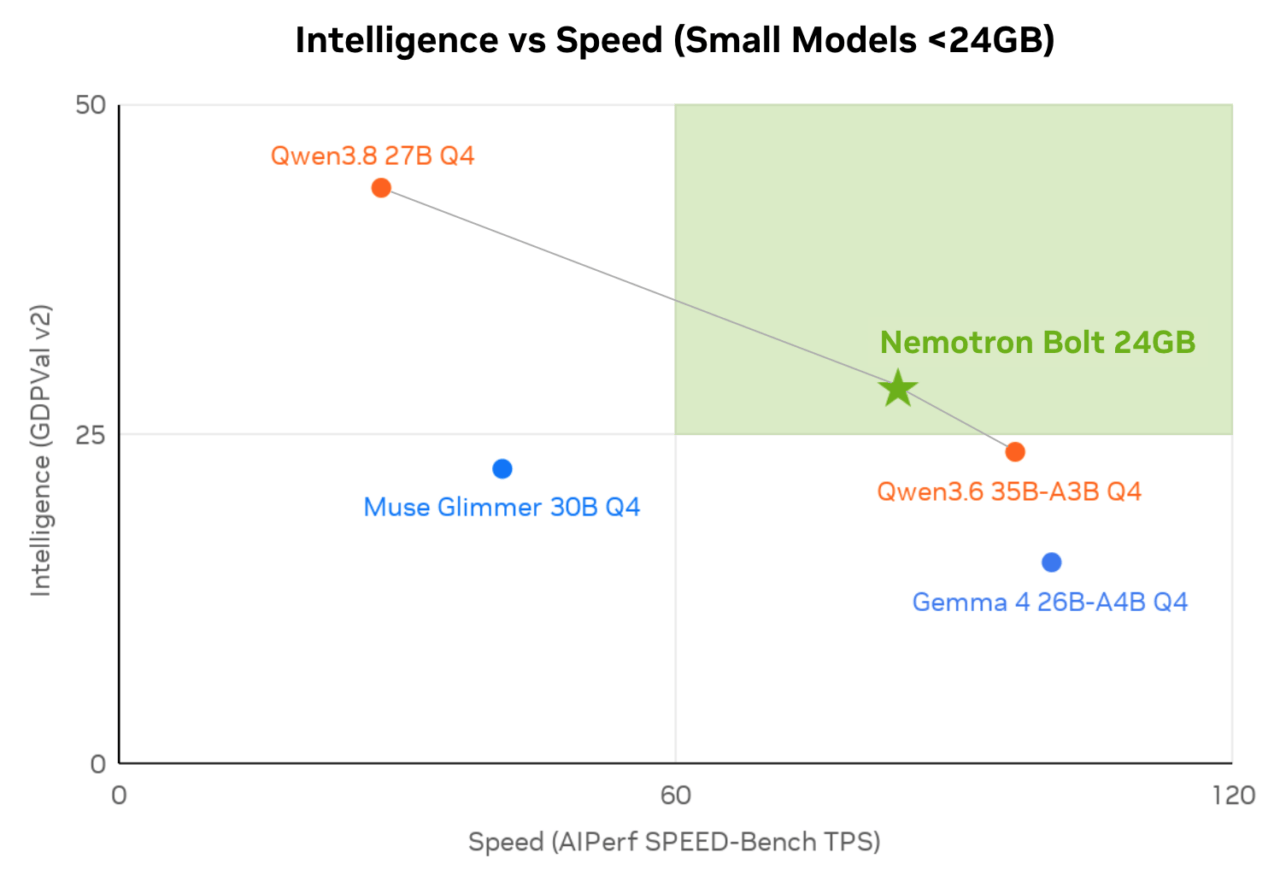
NVIDIA sendiri menyebut Super VL bisa berjalan di seluruh lini perangkatnya, mulai dari DGX Spark, DGX Station, RTX PRO, sistem RTX, Jetson, sampai data center. Untuk laptop RTX Spark dengan memori terpadu hingga 128GB, model ini secara teori masuk, tapi yang lebih realistis untuk laptop adalah Nemotron Bolt yang memang dirancang muat di 24GB.
Perbedaannya dengan model terbuka lain minggu ini
Minggu ini cukup ramai karena Meta juga merilis Muse Spark Open di waktu yang hampir bersamaan. Keduanya sama-sama model terbuka, tapi ukurannya sangat berbeda.
| Aspek | Nemotron 3.5 Super VL | Muse Spark Open |
|---|---|---|
| Pembuat | NVIDIA | Meta |
| Total parameter | 120B | 816B |
| Parameter aktif | 12B | 42B |
| Konteks | Hingga 1 juta token | 1 juta token |
| Input | Teks, gambar, video | Teks, gambar, video, audio |
| Skor Artificial Analysis | Sekitar 26 | 39 (menurut AT Pulse) |
Dari tabel ini, perbedaannya cukup jelas:
- Muse Spark Open lebih pintar di indeks umum, tapi ukurannya hampir tujuh kali lebih besar dan jauh lebih berat untuk dijalankan sendiri.
- Nemotron 3.5 Super VL lebih hemat dan lebih cepat, sehingga lebih cocok untuk agen yang harus jalan terus-menerus dengan volume tinggi.
Kalau ingin membaca detail Muse Spark Open, kami sudah membahasnya di artikel spek dan harga API Muse Spark Open.
Siapa saja yang sudah memakainya
NVIDIA menyebut puluhan perusahaan sedang melatih ulang (post-training) Super VL dengan data mereka sendiri. Beberapa nama besar yang disebut:
- Atlassian untuk pencarian berbasis agen di Jira dan Confluence.
- CrowdStrike untuk keamanan siber, khususnya agen pertahanan (blue team).
- Perplexity untuk Perplexity Search dan Computer.
- Salesforce untuk mengotomatiskan alur kerja pemerintahan.
- Scale AI yang melatih model ini untuk agen keuangan Skydance dan agen due diligence EY.
Menurut ringkasan yang beredar di X, Scale AI mengklaim agen keuangan Skydance berbasis Super VL bisa menyamai akurasi model tertutup yang dipakai sebelumnya, dengan biaya inferensi sekitar 40 kali lebih murah dan 5 kali lebih cepat. Klaim ini menarik, tapi tetap perlu dilihat sebagai studi kasus mitra, bukan uji independen.
Postingan peluncuran dari akun resmi NVIDIA di X sendiri sudah dilihat lebih dari 76 ribu kali dengan hampir 950 like. Reaksi yang muncul kebanyakan datang dari developer yang langsung membagikan hasil uji kecepatan di mesin masing-masing.
Yang relevan buat pengguna di Indonesia
Untuk developer, mahasiswa, dan tim kecil di Indonesia, ada beberapa hal praktis yang perlu diperhatikan:
- Bisa dicoba tanpa kartu kredit mahal. Varian gratis di OpenRouter cukup untuk eksperimen awal, misalnya membaca struk, faktur, atau tabel dari PDF.
- Harga berbayarnya ramah. Dengan sekitar Rp1.795 per sejuta token input, model ini cocok untuk UMKM atau startup yang ingin membuat fitur baca dokumen otomatis.
- Bahasa Indonesia belum disebut khusus. Laporan teknis NVIDIA menyebut pelatihan tambahan untuk bahasa-bahasa India (Indic), bukan bahasa Indonesia. Hasil untuk teks Indonesia sebaiknya diuji dulu sebelum dipakai di produksi.
- Menjalankan lokal masih mahal. Perangkat seperti DGX Spark atau laptop RTX Spark belum murah. Info harga laptop RTX Spark bisa dilihat di artikel harga NVIDIA RTX Spark.
- Cocok untuk data sensitif. Karena bobotnya terbuka, perusahaan yang punya server sendiri bisa menjalankan model ini tanpa mengirim dokumen ke cloud pihak ketiga.
Peringatan: Baca dulu lisensi OpenMDW-1.1 sebelum memakai model ini untuk produk komersial, terutama kalau ingin mendistribusikan versi yang sudah dilatih ulang.
Poin penting
- Nemotron 3.5 Super VL rilis 15 Oktober 2026 sebagai model terbuka 120B (12B aktif).
- Bisa membaca teks, gambar, PDF, dan video, dengan konteks hingga 1 juta token.
- Tersedia di Hugging Face, ModelScope, OpenRouter, NVIDIA NIM, dan dilaporkan sudah ada di AWS SageMaker JumpStart.
- Harga OpenRouter sekitar Rp1.795 per 1 juta token input dan Rp7.180 per 1 juta token output, plus ada varian gratis.
- Versi NVFP4 sudah bisa jalan di satu DGX Spark dengan kecepatan puluhan token per detik.
- Dukungan bahasa Indonesia belum disebut secara khusus, jadi perlu diuji sendiri.
Referensi
- NVIDIA Blog (2026). Open From Data Center to Desktop: NVIDIA Expands Nemotron Family With Highest Efficiency Super VL and Bolt Models
- NVIDIA Technical Blog (2026). NVIDIA Nemotron 3.5 Super VL Powers Specialized Agents with Multimodal Reasoning
- Hugging Face (2026). NVIDIA-Nemotron-3.5-Super-VL-120B-A12B-BF16 Model Card
- NVIDIA NIM (2026). nemotron-3.5-super-vl-120b-a12b Model Card
- NVIDIA Research (2026). Nemotron 3.5 Super and Lightning: Open, Efficient Mixture-of-Experts Hybrid Mamba-Transformer Models for Agentic AI
- OpenRouter (2026). NVIDIA Nemotron 3.5 Super VL Model Pricing
- The Guardian (2026). Meta releases Muse Spark Open, a new open-weight AI model
- AT Pulse (2026). Meta's Muse Spark Open, Nemotron 3.5 VL, ChatGPT in Chrome tabs
- Made With Models (2026). AI news — October 16, 2026
- X / NVIDIA, Pavlo Molchanov, Eduardo Dias, Stephen J Ronan, ft-lab (2026). Postingan peluncuran dan uji kecepatan Nemotron 3.5 Super VL
Pertanyaan Umum
Apakah Nemotron 3.5 Super VL benar-benar gratis?
Apa bedanya Nemotron 3.5 Super VL dengan Nemotron Bolt?
Bisakah model ini dijalankan di PC gaming biasa?
Apakah Nemotron 3.5 Super VL bisa memahami bahasa Indonesia?
Seberapa panjang video yang bisa dibaca?
Lisensinya apa, dan boleh dipakai untuk bisnis?
Kesimpulan
Nemotron 3.5 Super VL adalah langkah NVIDIA untuk memberi pilihan model terbuka yang bisa membaca teks dan visual sekaligus tanpa harus memakai model raksasa. Dengan 12B parameter aktif, konteks 1 juta token, dan klaim kecepatan hingga lima kali lipat di kelasnya, model ini menarik untuk agen yang harus mengolah banyak dokumen setiap hari.
Buat pengguna di Indonesia, cara paling mudah untuk mulai adalah mencoba varian gratis di OpenRouter. Kalau hasilnya cocok, harga berbayarnya juga masih sangat terjangkau. Satu hal yang tetap perlu diuji sendiri adalah kualitasnya untuk dokumen berbahasa Indonesia, karena NVIDIA belum menyebutnya secara khusus.
Komentar (0)
Belum ada komentar. Jadilah yang pertama berbagi pendapat!
Tinggalkan komentar