AI
Apa yang Baru di CursorBench 4.0? Bedah Long-Horizon Coding
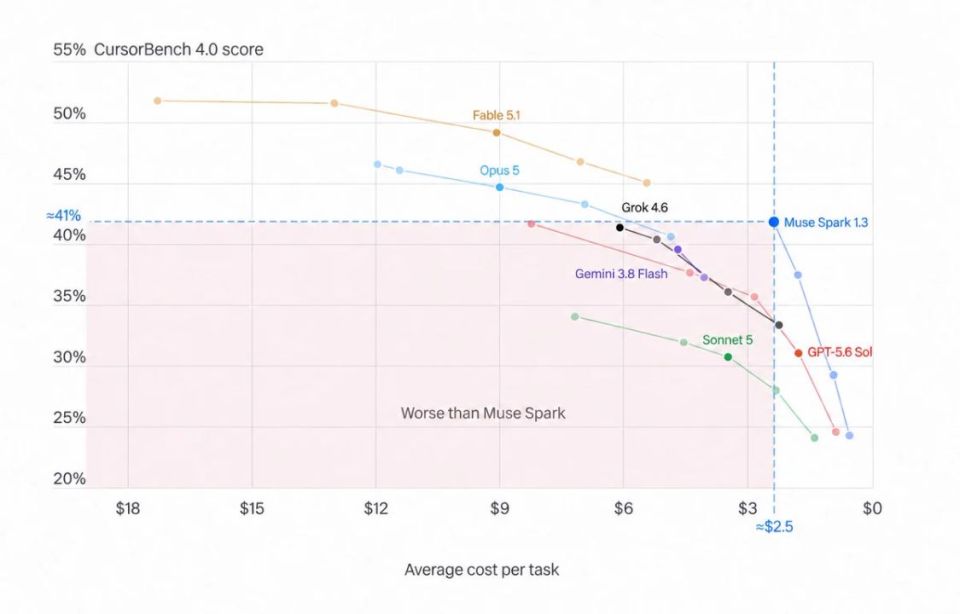
CursorBench 4.0 hadir sebagai standar evaluasi baru untuk menguji kemampuan model AI dalam menyelesaikan long horizon coding tasks.
CursorBench 4.0 hadir sebagai standar evaluasi baru untuk menguji kemampuan model AI dalam menyelesaikan long-horizon coding tasks. Versi terbaru ini dibuat buat membedah bagaimana agen AI mempertahankan konteks, merencanakan arsitektur, dan melakukan debugging mandiri pada repo besar tanpa kehilangan arah. Teman-teman yang berkecimpung di software development skala enterprise pasti tahu betapa sulitnya menjaga konsistensi agen AI saat berhadapan dengan basis kode yang kompleks.
Banyak framework evaluasi lama yang hanya menguji fungsi kecil atau potongan kode singkat berdurasi pendek. Padahal, skenario nyata di dunia kerja melibatkan migrasi library, refaktorisasi massal, hingga penanganan breaking changes lintas modul yang memakan waktu lama. Di sinilah update dari versi empat ini membawa sudut pandang analitik yang jauh lebih tajam bagi para developer dan tech lead.
Memahami Arsitektur Pengujian Tugas Jangka Panjang
Pengujian long-horizon menuntut ketahanan sistem dalam memproses ribuan baris token tanpa mengalami degradasi logika. CursorBench 4.0 memperkenalkan metrik pelacakan status internal yang memantau langkah demi langkah eksekusi agen. Pendekatan ini memastikan bahwa setiap perubahan kecil tidak merusak struktur global dari aplikasi yang sedang dibangun.
- Pelacakan status internal berbasis checkpointing inkremental untuk mencegah hilangnya memori agen saat memproses file dalam jumlah masif.
- Validasi sintaks otomatis di setiap akhir iterasi sub-task sebelum melanjutkan ke modul berikutnya guna memastikan tidak ada error yang terlewat.
- Mekanisme rollback cepat kalau agen mendeteksi adanya regresi fungsional pada kode yang sudah di-update sebelumnya.
flowchart TD
    A[Inisialisasi Prompt] --> B[Analisis Repositori]
    B --> C[Perencanaan Multi-Langkah]
    C --> D[Eksekusi Kode & Test Runner]
    D --> E{Ada Error?}
    E -- Ya --> F[Self-Healing & Patching]
    F --> D
    E -- Tidak --> G[Validasi Akhir & PR]
Melalui diagram alur di atas, terlihat bagaimana sistem memvalidasi ulang setiap tahapan sebelum melanjutkan ke instruksi berikutnya. Proses berulang ini meminimalkan risiko halusinasi kode yang sering terjadi pada iterasi model sebelumnya. Teman-teman bisa memeriksa docs resmi GitHub Organization untuk melihat spesifikasi dataset pengujian yang digunakan dalam update ini.
Tantangan Pemrosesan Konteks Luas pada repo Masif
Menghadapi basis kode dengan ukuran mencapai ratusan megabita menuntut efisiensi tinggi dari agen AI. Masalah utama yang sering muncul adalah bagaimana sistem melakukan indexing tanpa membebani memori utama server tempat benchmark dijalankan.
- Penggunaan teknik sparse attention untuk menyeleksi file relevan secara dinamis tanpa harus memuat seluruh isi direktori ke dalam context window.
- Pembatasan cakupan file (file scoping) agar agen tidak membaca direktori yang tidak berkaitan dengan tugas aktif.
- Optimalisasi vector database lokal untuk mempercepat proses pencarian fungsi atau kelas terkait secara instan.
Analisis Mendalam Kinerja Vector Database pada Repo Skala Besar
Pemilihan strategi penyimpanan vektor sangat menentukan seberapa cepat agen dapat menarik referensi kode dari direktori yang sangat luas.
- Hybrid Search Indexing: Menggabungkan pencarian berbasis kata kunci tradisional (BM25) dengan embedding semantik untuk akurasi ekstra tinggi dalam pencarian fungsi.
- Chunking Strategy: Memecah file sumber berdasarkan fungsi atau struktur kelas agar potongan token tidak terputus di tengah sintaks penting.
- Memory Footprint Monitoring: Menjaga penggunaan RAM server tetap di bawah batas aman selama proses embedding generation berjalan secara paralel.
Peningkatan Metrik Evaluasi dan Analisis Token
Kompleksitas tugas pemrograman jangka panjang sering terbentur pada masalah manajemen memori dan batas token context window. Versi 4.0 memecah evaluasi menjadi beberapa kategori spesifik untuk mengukur efisiensi penggunaan sumber daya komputasi secara transparan.
- Context Retention Rate: Mengukur seberapa baik agen mengingat instruksi awal setelah memproses ratusan file kode.
- Autonomous Error Recovery: Menghitung tingkat keberhasilan agen dalam membaca stack trace dan memperbaiki bug secara mandiri.
- Cross-File Dependency Mapping: Evaluasi kemampuan agen dalam melacak relasi antar modul yang saling terhubung dalam satu proyek.
Tips: Jangan langsung berasumsi skor tinggi pada benchmark pendek akan otomatis bagus di pengujian long-horizon. Pastikan teman-teman menguji agen dengan repo sampel lokal yang memiliki struktur direktori rumit.
Grafik berikut menunjukkan perbandingan performa rata-rata dalam menyelesaikan tugas refaktorisasi multi-file antara versi sebelumnya dan CursorBench 4.0.
Lonjakan angka tersebut mencerminkan peningkatan signifikan pada kemampuan penalaran spasial kode dari model AI modern. Ketika agen dihadapkan pada struktur direktori yang dalam, efisiensi penelusuran menjadi penentu utama keberhasilan eksekusi tugas.
Analisis Alokasi Memori dan Overhead Token
Setiap iterasi yang dilakukan agen dalam menyelesaikan tugas pemrograman jangka panjang akan mengonsumsi kuota token yang tidak sedikit. Memahami cara kerja konsumsi token ini membantu tim dalam menekan biaya operasional komputasi.
- Token Wastage Ratio: Mengukur seberapa banyak token yang terbuang untuk instruksi ulang yang tidak perlu.
- Prompt Caching Efficiency: Pakai fitur cache pada API model untuk mengurangi latensi pembacaan file berulang.
- Dynamic Truncation: Memotong log error yang terlalu panjang agar tidak memenuhi kuota context window.
Optimasi Token Window Lewat Pengaturan Kompak
Menjaga efisiensi kuota token butuh taktik khusus dalam merumuskan prompt sistem agar agen tidak mengalami token overflow di tengah jalan.
- Selective Payload Injection: Hanya menyertakan baris kode yang terdampak langsung oleh instruksi perbaikan.
- Summary Fallback: Mengganti riwayat chat yang panjang dengan ringkasan status operasional.
- Cost Allocation Tracking: Memantau penggunaan token per modul untuk mengidentifikasi skrip mana yang paling boros sumber daya.
Struktur Direktori dan Pengaturan Lingkungan Pengujian
Menyiapkan lingkungan untuk menjalankan rangkaian uji coba ini butuh ketelitian tinggi pada config berkas lokal. Berikut adalah contoh representasi struktur direktori standar yang digunakan dalam skenario pengujian long-horizon pada versi terbaru ini.
cursorbench-workspace/
├── .cursorbench/
│   ├── config.yaml
│   └── test-suites/
│       ├── refactor-core.json
│       └── migration-v2.json
├── src/
│   ├── controllers/
│   ├── models/
│   └── services/
└── package.json
Pengaturan berkasconfig.yamlDi dalam folder tersembunyi tersebut memuat parameter penting seperti batas iterasi agen, aturan rate limit, dan direktori target untuk sandbox execution. Teman-teman disarankan untuk membaca panduan integrasi melalui Python Package Index kalau ingin menghubungkan modul tambahan ke dalam kerangka kerja lokal.
Best Practice Penataan Workspace untuk Agentic Testing
Lingkungan kerja yang bersih sangat menentukan tingkat akurasi agen dalam membaca instruksi config. Kesalahan kecil pada hierarki folder bisa membuat agen salah mengidentifikasi entry point aplikasi.
- Letakkan file config utama tepat di dalam direktori tersembunyi
.cursorbench/Agar mudah dikenali oleh parser. - Pisahkan direktori test-suites berdasarkan jenis tugas, seperti migrasi database atau update framework frontend.
- Pastikan dependensi proyek eksternal sudah terinstal secara lokal sebelum agen mulai melakukan uji coba eksekusi kode.
Pengamanan Sandbox Tingkat Lanjut untuk Isolasi Lingkungan
Menjalankan agen dalam mode otonom butuh lapisan pengamanan tambahan agar skrip yang dieksekusi tidak merusak sistem operasi host.
- Network Isolation Policy: Memutus akses internet total pada kontainer uji coba kecuali untuk repo lokal terverifikasi.
- Filesystem Read-Only Mounts: Mengunci direktori sistem inti agar agen hanya memiliki izin tulis pada folder kerja proyek.
- Resource Quota Capping: Membatasi alokasi maksimal CPU dan memori per instance agen untuk mencegah lonjakan beban server.
Config Parameter dan Batas Eksekusi Agen
Mengatur batasan operasional agen sangat penting agar proses eksekusi tidak terjebak dalam infinite loop saat menemui error sintaks yang kompleks. Berkas config pada versi empat ini menyediakan opsi penyesuaian yang lebih fleksibel dibandingkan rilis terdahulu.
version: "4.0"
agent:
  max_steps: 50
  timeout_seconds: 3600
  allow_self_healing: true
  fallback_model: "standard-coder-v2"
sandbox:
  isolation: "docker"
  network_access: false
Peringatan: Menyalakan akses jaringan (
network_access: true) pada lingkungan sandbox tanpa pengawasan ketat bisa berisiko terhadap keamanan sistem lokal teman-teman. Selalu gunakan mode terisolasi penuh saat menguji agen pihak ketiga.
Pendekatan modular ini bikin developer menyesuaikan durasi maksimum eksekusi berdasarkan tingkat kerumitan tugas pemrograman yang diberikan kepada agen. Pengaturan fallback model juga berfungsi menjaga stabilitas jika model utama mengalami gangguan koneksi atau downtime.
Menyetel Parameter Timeout dan Threshold Iterasi
Mengontrol batas waktu eksekusi mencegah proses benchmark berjalan tanpa henti ketika agen mengalami jalan buntu dalam menyelesaikan suatu masalah logika.
- Tentukan
max_stepsAntara 30 hingga 60 langkah untuk tugas refaktorisasi berukuran sedang. - Gunakan parameter
timeout_secondsUntuk membatasi durasi total pengerjaan satu skenario pengujian. - Aktifkan log verbose pada mode debug jika ingin memantau detail setiap keputusan yang diambil agen secara real-time.
Config Fallback Model yang Tangguh
Menyiapkan model cadangan di dalam berkas config memastikan proses pengujian tetap berjalan meskipun model utama mengalami kendala kapasitas atau latensi tinggi.
- Automatic Failover Triggers: Menentukan ambang batas error HTTP atau timeout sebelum sistem beralih ke model cadangan.
- State Preservation on Switch: Memastikan riwayat checkpoint agen tetap terbawa secara mulus saat transisi model terjadi.
- Performance Baseline Verification: Membandingkan tingkat akurasi keluaran antara model utama dan model cadangan.
Hambatan Umum Saat Menjalankan Tugas Pemrograman Jangka Panjang
Meskipun fitur otomatisasi pada versi terbaru ini jauh lebih matang, beberapa kesalahan operasional masih sering dilakukan oleh developer saat pertama kali mencobanya. Memahami jebakan ini akan menghemat waktu debugging yang berharga bagi tim di lapangan.
Baca juga Bolt Forge Resmi Hadir AI Agent Open Weight Baru
- Mengabaikan manajemen cache lokal yang menyebabkan agen membaca versi file usang selama proses iterasi panjang.
- Menyetujui seluruh usulan perubahan kode tanpa meninjau ulang diff pada modul kritis yang mengatur autentikasi atau database.
- Memaksa agen menyelesaikan tugas masif dalam satu instruksi tunggal alih-alih memecahnya menjadi beberapa sub-tugas terstruktur.
Diagram di atas mengilustrasikan bagaimana logika pemecahan tugas bekerja secara otomatis di belakang untuk menjaga akurasi keluaran agen. Pendekatan terstruktur ini terbukti mampu menekan angka kegagalan hingga setengah dari versi sebelumnya. Pelajari soal standar industri pengujian software melalui IEEE Computer Society untuk memperkaya wawasan metodologi pengembangan.
Mengatasi Konflik Dependensi dan Broken Imports
Salah satu masalah paling sering terjadi saat agen AI memodifikasi file secara masif adalah terputusnya jalur import antar modul akibat perubahan nama fungsi atau direktori.
- Gunakan static analysis tool pihak ketiga untuk mendeteksi broken imports sebelum proses commit otomatis dijalankan.
- Pastikan agen memiliki akses ke skrip linter proyek agar format kode tetap konsisten dengan standar tim.
- Lakukan verifikasi manual pada file config seperti
package.jsonAtaurequirements.txtSetelah agen selesai melakukan migrasi library.
Strategi Pemulihan Ketika Terjadi Infinite Loop Agen
Terjebak dalam perulangan langkah yang tidak berujung adalah salah satu risiko utama saat agen mencoba memperbaiki error logika yang kompleks.
- Loop Detection Heuristics: Menghentikan proses jika agen mengeksekusi pola perintah file yang identik selama lebih dari lima iterasi berturut-turut.
- Manual Intervention Point: Menyediakan tombol interupsi darurat di dalam dashboard CLI untuk mengambil alih kontrol secara manual.
- Post-Mortem Log Analysis: Memeriksa file dump log untuk mengidentifikasi pemicu utama mengapa agen gagal menemukan solusi logis.
Menilai Kapan Harus Pakai Evaluasi Otomatis Ini
Tidak semua proyek pengembangan butuh kerangka evaluasi serumit CursorBench 4.0. Untuk proyek berskala kecil atau pembuatan purwarupa sederhana, penggunaan alat uji manual yang ringan sering jauh lebih efisien dari segi waktu maupun biaya komputasi.
- Gunakan benchmark ini saat mengelola repo dengan jumlah file melebihi seratus unit.
- Pilih pendekatan manual untuk proyek scripting satu file atau aplikasi skala mikro.
- Terapkan evaluasi bertahap pada pipeline CI/CD untuk memantau performa agen secara konsisten.
Gunakan evaluasi berbasis long-horizon ini saat teman-teman mengelola repo monorepo dengan ratusan ribu baris kode aktif yang melibatkan banyak kontributor sekaligus. Sebaliknya, skip atau tunda migrasi ke versi empat ini jika proyek masih berada pada tahap eksplorasi awal yang rentan mengalami perombakan total pada arsitektur dasarnya. Keputusan yang tepat dalam memilih perangkat uji akan menjaga produktivitas tim tetap stabil tanpa terjebak dalam kompleksitas config yang tidak perlu.
Strategi Integrasi ke dalam Pipeline CI/CD Tim
Memasukkan rangkaian pengujian long-horizon ke dalam sistem integrasi jangka panjang butuh alokasi sumber daya server khusus agar tidak mengganggu proses build utama aplikasi.
- Jalankan benchmark CursorBench 4.0 pada runner terpisah yang dilengkapi isolasi sandbox berbasis kontainer.
- Jadwalkan pengujian penuh pada waktu-waktu tertentu, misalnya saat nightly build, untuk menghemat biaya komputasi.
- Buat laporan otomatis yang merangkum metrik context retention dan tingkat keberhasilan self-healing setiap kali ada update model agen.
Evaluasi Lanjutan untuk Skala Perusahaan Enterprise
Bagi organisasi besar yang mengelola ratusan repo secara bersamaan, standarisasi pengujian agen butuh tata kelola infrastruktur yang terpusat.
- Centralized Benchmark Dashboard: Menggabungkan hasil metrik dari berbagai tim developer ke dalam satu panel kontrol analitik tunggal.
- Custom Metric Weights: Menyesuaikan bobot penilaian metrik berdasarkan fokus bisnis perusahaan, apakah itu kecepatan rilis atau keamanan kode.
- Cross-Team Compliance Audit: Memastikan setiap agen AI yang digunakan mematuhi standar lisensi kode internal perusahaan sebelum diintegrasikan ke production branch.
Analisis Komparatif Performa Model Lintas Generasi
Memahami peningkatan kapabilitas agen butuh perbandingan langsung terhadap cara model menangani struktur kode yang kompleks. Versi terbaru ini mengukur variasi kemampuan penalaran lintas berbagai framework populer.
- Zero-Shot Generalization: Menguji bagaimana agen beradaptasi dengan codebase baru tanpa pelatihan spesifik sebelumnya.
- Multi-File Reasoning Depth: Menghitung jumlah file maksimal yang dapat dimodifikasi secara akurat dalam satu siklus instruksi.
- Syntax Error Rate Reduction: Persentase penurunan error sintaks setelah agen menerapkan perbaikan otomatis.
graph LR
    subgraph Generasi Sebelumnya
        A1[Analisis File Tunggal] --> B1[Perbaikan Lokal]
        B1 --> C1[Potensi Broken Import]
    end
    subgraph CursorBench 4.0
        A2[Analisis Global Repo] --> B2[Perencanaan Multi-Modul]
        B2 --> C2[Self-Healing Terintegrasi]
    end
Diagram perbandingan di atas memperjelas pergeseran paradigma dari pendekatan analisis file tunggal menuju pemahaman repo semua. Dengan arsitektur baru ini, agen mampu mengantisipasi dampak perubahan pada file lain yang tidak tersentuh secara langsung oleh instruksi utama.
Mengoptimalkan Config Agentic Workflow
Pengaturan alur kerja agen yang optimal sangat menentukan seberapa mulus proses eksekusi kode berjalan di lingkungan pengembangan lokal maupun server staging.
- Pastikan parameter memori cache diatur secara tepat agar proses indexing direktori besar tidak memakan waktu lama.
- Gunakan fitur dry-run sebelum memberikan izin penuh kepada agen untuk melakukan commit otomatis ke repository utama.
- Tinjau laporan log iterasi untuk mendeteksi potensi inefisiensi dalam penggunaan token model.
Optimasi Lanjutan Manajemen Ketergantungan Lintas Direktori
Mengelola dependensi dalam skala besar menuntut ketelitian ekstra dari sistem pengujian agen agar tidak terjadi inkonsistensi versi paket. CursorBench 4.0 menyematkan modul pelacak relasi file yang bekerja secara paralel dengan engine utama.
- Package Version Lock Validation: Memeriksa kompatibilitas versi modul eksternal sebelum agen mengeksekusi skrip migrasi.
- Circular Dependency Detection: Mencegah agen membuat referensi melingkar antar modul yang dapat memicu stack overflow saat runtime aplikasi.
- Automated Stub Generation: Membuat file stub sementara untuk modul yang belum diimplementasikan agar proses pengujian tidak terhenti di tengah jalan.
Mitigasi Konflik Merge Otomatis oleh Agen
Ketika agen melakukan update kode pada beberapa branch secara simultan, risiko terjadinya konflik merge git sangat tinggi jika tidak dikelola dengan benar.
- Terapkan strategi rebase otomatis sebelum agen melakukan push hasil perubahan ke branch staging.
- Gunakan aturan resolusi konflik berbasis prioritas timestamp untuk file config yang sering diubah bersamaan.
- Lakukan verifikasi unit test terisolasi pada setiap hasil merge sebelum modul digabungkan ke branch utama.
Pengukuran Latensi Eksekusi dan Throughput Token
Kecepatan respons agen dalam menyelesaikan tugas pemrograman jangka panjang sangat memengaruhi efisiensi waktu pengerjaan proyek secara keseluruhan. Versi terbaru ini menyediakan metrik analitik mendalam terkait latensi jaringan dan pemrosesan model.
- Time-to-First-Token (TTFT): Mengukur seberapa cepat model merespons instruksi awal setelah menerima payload direktori.
- Throughput Tokens per Second: Menghitung kecepatan generasi kode oleh model selama proses refactoring massal berjalan.
- Network Latency Compensation: Menyesuaikan batas timeout secara otomatis berdasarkan kondisi beban server API model.
Penanganan Kegagalan API dan Rate Limiting Eksternal
Ketergantungan pada model bahasa eksternal membuat sistem rentan terhadap gangguan jaringan atau pembatasan kuota (rate limiting) dari penyedia layanan.
- Exponential Backoff Retry: Mengatur jeda waktu tunggu secara bertahap saat agen menerima respons error HTTP 429 atau 503.
- Multi-Provider Load Balancing: Mengalihkan permintaan komputasi ke model cadangan secara otomatis saat penyedia utama mengalami gangguan layanan.
- Local State Caching: Menyimpan hasil pemrosesan sementara di memori lokal agar tidak perlu melakukan re-query saat terjadi kegagalan koneksi mendadak.
Rekomendasi Penggunaan Hardware untuk Runner Lokal
Menjalankan proses benchmark secara mandiri di infrastruktur lokal butuh spesifikasi hardware yang memadai agar simulasi berjalan lancar tanpa hambatan performa.
- Processor Cores: Minimal pakai CPU dengan 8 core fisik untuk menangani proses sandbox dan test runner secara paralel.
- Memory RAM: Sediakan setidaknya 32 GB RAM agar proses indexing direktori besar dan manajemen vector database tidak kehabisan memori.
- Storage Speed: Gunakan NVMe SSD berkecepatan tinggi untuk mempercepat proses I/O file selama iterasi agen berlangsung.
Pemeliharaan Log Sistem dan Audit Keamanan Berkala
Menganalisis file log membantu tim developer dalam memahami pola kegagalan agen dan meningkatkan kualitas instruksi sistem dari waktu ke waktu.
- Log Rotation Policy: Mengatur penghapusan otomatis file log lama untuk menghemat kapasitas penyimpanan media server.
- Sensitive Data Redacting: Menyaring informasi kredensial atau API key agar tidak terekam ke dalam file log publik secara tidak sengaja.
- Security Audit Trail: Mencatat setiap aktivitas modifikasi file yang dilakukan oleh agen untuk keperluan evaluasi kepatuhan kode perusahaan.
Checklist
- Atur batas langkah maksimal agen antara 30 hingga 60 langkah untuk mencegah perulangan tanpa henti.
- Aktifkan mode isolasi kontainer Docker dan matikan akses jaringan pada lingkungan sandbox.
- Pasang file config utama tepat di dalam direktori tersembunyi .cursorbench/ agar mudah dikenali parser.
- Pisahkan direktori test-suites berdasarkan jenis tugas spesifik seperti migrasi database atau update framework.
- Terapkan teknik sparse attention dan file scoping untuk membatasi cakupan pembacaan file pada repo masif.
- Gunakan fitur cache pada API model untuk meminimalkan latensi pembacaan file berulang.
- Siapkan model cadangan di dalam berkas config untuk mengantisipasi gangguan latensi atau penurunan kapasitas.
- Lakukan verifikasi manual pada file config seperti package.json setelah agen menyelesaikan proses migrasi library.
- Tinjau laporan log iterasi untuk mendeteksi potensi inefisiensi dalam penggunaan kuota token.
Poin penting
- CursorBench 4.0 menguji kemampuan agen AI menyelesaikan tugas pemrograman jangka panjang secara mandiri.
- Pelacakan status internal berbasis checkpointing mencegah hilangnya memori saat memproses file masif.
- Penggunaan teknik sparse attention menyeleksi file relevan tanpa membebani context window server.
- Hybrid search indexing menggabungkan BM25 dan embedding semantik untuk akurasi pencarian fungsi.
- Evaluasi versi terbaru memecah metrik menjadi context retention dan autonomous error recovery.
Referensi
- Wikipedia (2026). 4 (disambiguation)
- Wikipedia (2026). 4 (number)
- Wikipedia (2026). 4
- Newworldencyclopedia (2026). 4 (number)
- Fandom (2026). 4 | NumbersWiki
- Facts (2026). 8 Fun Facts About the Number 4
- Google (2026). Channel 4
- YouTube (2026). Learn About the Number 4
- YouTube (2026). 4
- Channel4 (2026). Channel 4
Pertanyaan Umum
Apa itu CursorBench 4.0 dan apa fokus utamanya?
Mengapa pengujian long-horizon penting untuk software development modern?
Bagaimana cara kerja pelacakan status internal dalam versi terbaru ini?
Kapan sebaiknya tim memilih pakai CursorBench 4.0?
Kesimpulan
CursorBench 4.0 membawa standar baru yang sangat dibutuhkan dalam menguji ketahanan agen AI untuk menyelesaikan tugas pemrograman jangka panjang. Melalui pendekatan pelacakan status berbasis checkpointing inkremental serta efisiensi pemrosesan konteks lewat sparse attention, kerangka evaluasi ini mampu meminimalkan risiko regresi pada basis kode berskala besar.
Bagi teman-teman yang mengelola repo kompleks dengan ratusan modul, pemanfaatan metrik analitik pada versi terbaru ini membantu memastikan agen tetap konsisten merencanakan arsitektur dan melakukan debugging mandiri. Evaluasi yang terstruktur dengan baik tidak hanya menghemat waktu operasional, tetapi juga menjaga stabilitas sistem secara keseluruhan. Mulailah mengintegrasikan pengujian berbasis long-horizon ini pada lingkungan staging untuk mengoptimalkan performa pengembangan proyek teman-teman.
Komentar (0)
Belum ada komentar. Jadilah yang pertama berbagi pendapat!
Tinggalkan komentar