AI
Gemini API Free Tier Batas RPM Dan TPM Terbaru
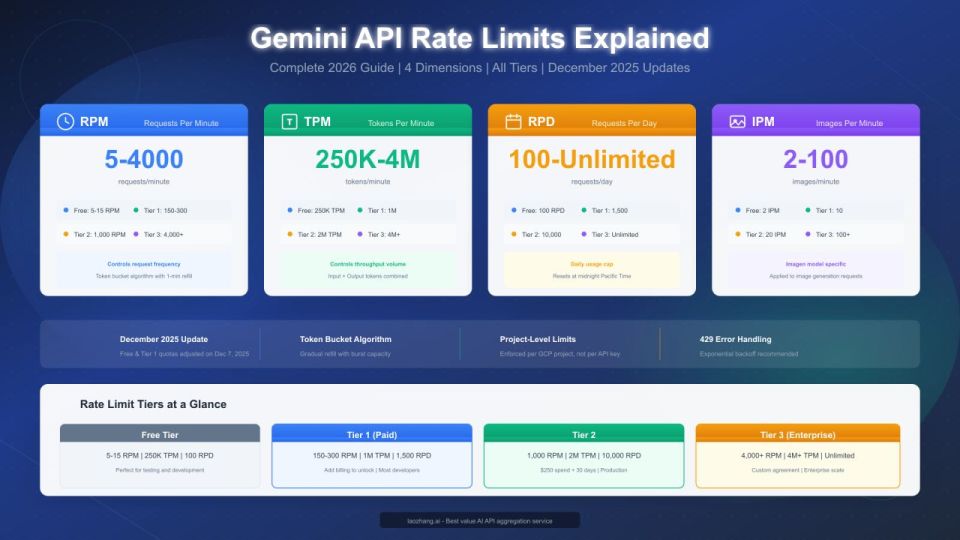
Mengandalkan Gemini API free tier untuk kebutuhan development sering menguji kesabaran saat traffic mulai naik.
Mengandalkan Gemini API free tier untuk kebutuhan development sering menguji kesabaran saat traffic mulai naik. Batasan kuota yang ketat di Google AI Studio membuat banyak developer harus memutar otak agar aplikasi tidak mendadak mengembalikan status error.
Masalah utama dari tier gratis ini bukan sekadar lambat, tapi limit kuota harian dan per menit yang gampang habis kalau setup-nya kurang bersih.
Memahami Angka Pembatas RPM, TPM, dan RPD

Sebelum menyusun kode, teman-teman wajib tahu dulu angka pasti dari batasan yang diberikan Google untuk tier gratis. Setiap model memiliki parameter kuota yang berbeda, dan salah membaca angka ini bisa bikin aplikasi production langsung macet total di tengah jalan.
Berdasarkan AI Free API Guide, parameter pembatas dibagi menjadi tiga metrik utama yang berjalan bersamaan:
- RPM (Requests Per Minute): Batasan jumlah API call dalam rentang waktu enam puluh detik.
- TPM (Tokens Per Minute): Total akumulasi token (prompt plus completion) yang bisa diproses dalam satu menit.
- RPD (Requests Per Day): Kuota maksimal panggilan yang boleh dilakukan dalam satu hari kalender penuh.
Model kelas berat seperti Gemini 2.5 Pro biasanya dipatok sangat ketat di angka 100 RPD saja pada tier gratis. Sementara itu, varian Flash memberikan kelonggaran hingga 1.500 RPD untuk kebutuhan uji coba harian.
Dalam praktiknya, batasan ini tidak bekerja secara terisolasi. Ketika aplikasi teman-teman mengirimkan satu request besar yang berisi ribuan token, limit TPM bisa langsung tercapai meskipun batas RPM baru terpakai satu atau dua kali saja. Makanya, pemahaman mendalam mengenai struktur payload sangat menentukan seberapa efisien kuota harian terpakai.
- Analisis Token Masuk: Selalu hitung estimasi token sebelum mengirim prompt panjang ke endpoint Gemini API.
- Batasi Konteks Historis: Jangan terus-menerus mengirim riwayat chat yang terlalu panjang dalam satu payload jika tidak benar-benar dibutuhkan oleh model.
- Gunakan Pemotongan Teks: Lakukan chunking pada dokumen besar sebelum memasukkannya ke dalam parameter API.
Tips: HEMAT — Selalu pantau penggunaan kuota harian langsung melalui dashboard Google AI Studio agar tidak terkecoh oleh lonjakan trafik mendadak dari proses background skrip.
Menghadapi Error 429 Terlalu Banyak Request
Error 429 Too Many Requests adalah pemandangan paling akrab bagi siapa saja yang mengandalkan API gratisan. Masalah ini muncul seketika saat aplikasi melakukan loop otomatis atau menerima lonjakan trafik mendadak dari user.
Peringatan: Jangan pernah melakukan retry instan tanpa jeda waktu saat menerima kode error 429. Tindakan ini justru akan memperpanjang blokir IP atau proyek teman-teman di server Google.
Strategi paling aman untuk menangani error ini adalah menerapkan algoritma exponential backoff pada kode klien. Setiap kali terjadi kegagalan akibat limit, tambahkan waktu tunggu yang bertambah secara eksponensial sebelum mencoba koneksi ulang.
Selain itu, penambahan komponen jitter pada jeda waktu sangat membantu untuk mencegah fenomena thundering herd, di mana banyak instance aplikasi secara bersamaan melakukan retry pada detik yang sama persis. Pendekatan ini menjaga stabilitas jaringan dan menurunkan risiko penolakan lanjutan dari server API.
- Waktu Tunggu Awal: Mulai dari jeda 1 detik pada kegagalan pertama request Gemini API.
- Pengali Eksponensial: Lipat gandakan waktu tunggu pada setiap percobaan berikutnya (1s, 2s, 4s, 8s).
- Batas Maksimal Percobaan: Tetapkan batas maksimal misalnya 5 kali percobaan sebelum menyerah dan memberikan pesan error yang ramah kepada user.
Strategi Rotasi Multiple API Key di Python
Kalau kuota dari satu akun Google AI Studio sudah habis tersedot, trik klasik yang sering dipakai developer open source adalah menyiapkan cadangan beberapa kunci API sekaligus. Pendekatan ini diadopsi oleh berbagai wrapper mandiri untuk mendistribusikan beban kerja secara otomatis.
Berikut adalah contoh skema sederhana rotasi kunci API pakai bahasa Python agar aplikasi bisa melakukan fallback mandiri:
import time
import google.generativeai as genai

class GeminiKeyRotator:
    def __init__(self, api_keys):
        self.api_keys = api_keys
        self.current_index = 0

    def get_active_model(self, model_name="gemini-2.5-flash"):
        genai.configure(api_key=self.api_keys[self.current_index])
        return genai.GenerativeModel(model_name)

    def rotate_key(self):
        self.current_index = (self.current_index + 1) % len(self.api_keys)
        print(f"Beralih ke API key index: {self.current_index}")

keys = ["AIzaSy_KeySatu...", "AIzaSy_KeyDua..."]
rotator = GeminiKeyRotator(keys)
Dengan teknik rotasi di atas, saat key pertama menyentuh batas TPM atau RPM, fungsi sistem bisa langsung memindahkan beban ke key berikutnya tanpa menghentikan proses utama secara keseluruhan.
Namun, teman-teman harus tetap berhati-hati agar tidak melanggar ketentuan layanan Google terkait pembuatan akun ganda. Pastikan setiap kunci API berasal dari akun Google yang sah dan dikelola secara transparan untuk menghindari pemblokiran massal pada seluruh proyek yang terhubung.
- Pemisahan Akun: Gunakan akun Google berbeda untuk menghasilkan kunci API cadangan yang independen.
- Logging Rotasi: Catat setiap kejadian perpindahan kunci ke dalam log sistem untuk mendeteksi pola konsumsi kuota harian.
- Validasi Berkala: Lakukan uji coba ping sederhana secara otomatis untuk memastikan kunci cadangan masih aktif dan belum kedaluwarsa.
Memilih Antara Varian Flash dan Pro Sesuai Kebutuhan
Kesalahan fatal yang sering dilakukan developer pemula adalah langsung memakai model Pro untuk seluruh tugas sepele. Padahal, untuk keperluan parsing teks biasa atau ekstraksi data sederhana, varian Flash sudah lebih dari cukup dan jauh lebih hemat kuota.
- Gunakan Gemini Flash: Untuk tugas berulang, chat bot harian, ringkasan teks panjang, dan proses data berkecepatan tinggi yang butuh RPM longgar.
- Gunakan Gemini Pro: Hanya untuk penalaran tingkat tinggi, analisis kode kompleks, atau pemecahan logika matematis yang butuh akurasi maksimal.
Melalui perhitungan matematis sederhana di atas, terlihat jelas bahwa memakai model Pro untuk tugas kecil akan menghabiskan kuota harian dalam hitungan menit saja.
Pemilihan model yang tepat juga berdampak langsung pada latensi aplikasi yang dirasakan oleh end-user. Model Flash dibuat untuk merespons dengan cepat, sehingga sangat ideal untuk interface obrolan real-time yang menuntut kecepatan tinggi tanpa jeda panjang.
- Uji Coba Berjenjang: Selalu mulai pengembangan fitur baru pakai model Flash sebelum memutuskan apakah model Pro benar-benar dibutuhkan.
- Kombinasi Hibrida: Gunakan model Flash untuk menyaring data awal, lalu teruskan bagian kompleks tertentu ke model Pro jika diperlukan.
- Evaluasi Biaya Token: Perhatikan ukuran input prompt karena model Pro mengonsumsi kuota jauh lebih cepat per karakter teks dibandingkan model Flash.
Mengatur Waktu yang Tepat untuk Upgrade ke Tier Berbayar
Meskipun tier gratis sangat menggoda untuk menghemat biaya operasional awal, ada titik di mana layanan ini tidak lagi memadai untuk skala produk. Bertahan di kuota gratis saat aplikasi sudah masuk tahap public launch justru akan merusak pengalaman user akibat downtime berkala.
- Tetap di Free Tier: Selama aplikasi masih dalam tahap local prototyping, pengujian fitur internal, atau skrip otomatisasi ringan berkapasitas di bawah 100 request per hari.
- Wajib Upgrade ke Pay-as-you-go: Ketika aplikasi sudah mulai diakses user eksternal, butuh stabilitas latensi, atau mencatat lonjakan error 429 secara konsisten setiap sore.
Transisi ke tingkat berbayar di Google Cloud Console tidak butuh perombakan kode yang rumit karena endpoint dan library yang digunakan tetap sama persis. Teman-teman hanya perlu mengaktifkan metode penagihan pada proyek yang bersangkutan untuk melepaskan batasan ketat tersebut.
Ketika memutuskan untuk beralih ke tingkat berbayar, manajemen anggaran menjadi aspek krusial yang harus diperhatikan agar tagihan bulanan tidak membengkak di luar kendali. Tetapkan batasan anggaran pada konsol Google Cloud untuk memantau pengeluaran.
Baca juga Bolt Forge Resmi Hadir AI Agent Open Weight Baru
- Monitor Pengeluaran Harian: Periksa grafik konsumsi token setiap minggu untuk mendeteksi potensi kebocoran kueri pada aplikasi.
- Optimalkan Payload: Hapus parameter yang tidak perlu dalam prompt untuk menekan jumlah token yang diproses oleh server.
- Gunakan Caching: Terapkan mekanisme response caching pada data yang sering diakses agar aplikasi tidak memanggil API secara berulang untuk pertanyaan yang sama.
Mengatasi Bottleneck Performa pada Skrip Asinkron
Saat mengembangkan aplikasi dengan frekuensi panggilan tinggi, penggunaan kode sinkron biasa akan sangat menghambat eksekusi program. Setiap request harus menunggu respons selesai sebelum baris kode berikutnya dieksekusi, yang berakibat pada pemborosan waktu tunggu.
Penerapan pemrograman asinkron (async/await) di Python atau JavaScript menjadi solusi mutlak untuk memaksimalkan efisiensi pemanfaatan batas RPM yang tersedia tanpa melanggar aturan pembatasan dari server.
- Gunakan Event Loop: Manfaatkan library asyncio untuk menjalankan beberapa kueri secara konkuren dalam batasan waktu tertentu.
- Batasi Semaphore: Terapkan pembatas konkurensi agar jumlah panggilan paralel tidak secara bersamaan menembus batas RPM harian.
- Tangkap Pengecualian Asinkron: Pastikan blok
try-exceptMembungkus setiap pemanggilan fungsi asinkron agar satu kegagalan tidak mematikan seluruh antrean tugas.
Berikut adalah ilustrasi implementasi pemanggilan asinkron pakai library modern untuk mengelola antrean request secara terstruktur:
import asyncio
import aiohttp

async def fetch_gemini_data(session, prompt):
    url = "https://generativelanguage.googleapis.com/v1beta/models/gemini-2.5-flash:generateContent"
    # Implementasi logika pemanggilan asinkron di sini
    pass
Dengan pendekatan asinkron ini, aplikasi teman-teman dapat mengirimkan sekumpulan tugas secara teratur, meminimalkan waktu idle, dan menjaga stabilitas eksekusi program secara keseluruhan.
- Manajemen Koneksi HTTP: Gunakan connection pooling agar klien tidak membuka socket baru di setiap API call yang berulang.
- Antrean Prioritas: Pisahkan antrean request penting dari tugas latar belakang agar user tidak menunggu terlalu lama.
- Timeout Ketat: Pasang parameter timeout yang jelas pada setiap pemanggilan async agar aplikasi tidak menggantung saat server Gemini mengalami kendala.
Mengoptimalkan Ukuran Prompt untuk Menjaga Batas TPM
Batasan Tokens Per Minute sering menjadi jebakan paling tersembunyi bagi developer karena ukurannya dihitung berdasarkan total karakter gabungan antara prompt input dan completion output dari model.
Jika teman-teman mengirimkan seluruh dokumen teks mentah berukuran besar ke dalam satu API call, kuota TPM satu menit penuh bisa langsung ludes hanya dalam satu atau dua kali eksekusi saja.
- Ringkas Instruksi Sistem: Buat system instructions yang padat, lugas, dan langsung pada inti tugas tanpa kalimat pengantar yang bertele-tele.
- Hilangkan Spasi Berlebih: Bersihkan string input dari karakter kosong yang tidak perlu sebelum dikirim ke payload API.
- Gunakan Format Ringkas: Pilih format data seperti JSON minimalis alih-alih teks naratif panjang saat mengirimkan data terstruktur ke model.
Pendekatan optimasi ini tidak hanya menghemat kuota TPM, tapi juga mempercepat waktu pemrosesan server karena model AI memiliki lebih sedikit token kosong yang harus dianalisis sebelum menghasilkan jawaban yang akurat.
- Audit Prompt Berkala: Tinjau ulang template prompt setiap bulan untuk melihat bagian mana saja yang bisa dipotong tanpa mengurangi kualitas keluaran.
- Gunakan Tokenizer Lokal: Manfaatkan library tokenizer resmi secara lokal di sisi klien untuk mengukur jumlah token secara pasti sebelum request dikirimkan ke cloud.
- Hindari Redundansi: Jangan menyertakan informasi latar belakang yang sama secara berulang-ulang di setiap giliran percakapan chat bot.
Menerapkan Mekanisme Caching untuk Respons Berulang
Salah satu cara paling efektif untuk menghemat kuota RPD dan TPM pada tier gratis adalah dengan menghindari pemanggilan API yang tidak perlu untuk pertanyaan atau tugas yang sifatnya repetitif.
Banyak aplikasi melakukan kueri berulang untuk data statis yang jarang berubah. Dengan menerapkan sistem caching lokal pakai Redis, SQLite, atau bahkan dictionary memori sederhana, beban terhadap Gemini API dapat ditekan banyak.
- Cache Berbasis Hash: Buat kunci unik dari string prompt yang dikirim oleh user sebagai identifier penyimpanan cache.
- Terapkan TTL (Time to Live): Berikan masa kedaluwarsa yang wajar pada data tersimpan agar informasi tetap relevan seiring berjalannya waktu.
- Validasi Pertanyaan Serupa: Gunakan teknik pencocokan semantik ringan untuk mendeteksi pertanyaan dengan maksud serupa agar langsung dijawab dari cache lokal.
Penerapan caching ini terbukti mampu memotong penggunaan kuota harian hingga lebih dari separuh, terutama pada aplikasi yang melayani FAQ atau tugas pemrosesan teks standar yang sering diakses oleh banyak user sekaligus.
- Kurangi Latensi: User mendapatkan respons secara instan tanpa harus menunggu proses inferensi dari server Google.
- Lindungi Kuota: Menjaga agar batas RPM dan RPD tetap aman dari lonjakan trafik yang bersumber dari pertanyaan berulang.
- Efisiensi Infrastruktur: Mengurangi ketergantungan penuh pada koneksi internet eksternal untuk fungsi-fungsi dasar aplikasi.
Pemantauan Log dan Penanganan Kegagalan Sistem secara Real-Time
Mengembangkan aplikasi berbasis AI tanpa sistem logging yang memadai ibarat mengemudi mobil di malam hari tanpa lampu utama. Teman-teman tidak akan pernah tahu kapan kuota akan habis sampai aplikasi benar-benar berhenti merespons.
Pencatatan log yang komprehensif membantu mengidentifikasi pola penggunaan, mendeteksi lonjakan error 429, dan memudahkan proses debugging saat terjadi kegagalan koneksi di lingkungan produksi.
- Catat Kode HTTP: Selalu simpan status respons HTTP dari setiap API call ke dalam sistem log eksternal.
- Monitor Waktu Eksekusi: Ukur durasi latensi setiap request untuk mendeteksi potensi kelambatan jaringan dari sisi server Google.
- Buat Peringatan Otomatis: Integrasikan sistem log dengan webhook pemberitahuan untuk segera melapor saat terjadi lonjakan error rate yang tinggi.
Dengan infrastruktur pemantauan yang baik, tim developer dapat mengambil tindakan pencegahan sebelum end user menyadari adanya gangguan layanan pada aplikasi yang sedang berjalan.
- Analisis Tren User: Pelajari jam-jam sibuk di mana trafik request mencapai puncaknya agar bisa mengatur strategi rotasi kunci atau penjadwalan ulang tugas latar belakang.
- Audit Penggunaan Token: Evaluasi rata-rata konsumsi token per user untuk merancang proyeksi kebutuhan anggaran jika kelak harus beralih ke tier berbayar.
- Uji Ketahanan Sistem: Lakukan simulasi lonjakan beban untuk memastikan mekanisme fallback berjalan sesuai rencana.
Manajemen State Aplikasi Berbasis Sesi untuk Mengurangi Overhead Payload
Banyak developer pemula melakukan kesalahan fatal dengan mengirimkan seluruh riwayat obrolan dari awal hingga akhir pada setiap pemanggilan Gemini API. Pendekatan ini membuat ukuran payload membengkak secara eksponensial seiring bertambahnya durasi percakapan.
Ketika ukuran prompt melewati ambang batas token per menit, server akan langsung menolak permintaan dengan error pembatasan rate limit. Makanya, pengelolaan state percakapan di sisi klien menjadi hal mutlak yang harus diperhatikan.
- Gunakan Sliding Window: Batasi riwayat chat hanya pada interaksi terakhir yang paling relevan dengan pertanyaan aktif sekarang.
- Lakukan Ringkasan Berkala: Ubah percakapan panjang menjadi satu paragraf ringkasan kontekstual sebelum memasukkannya kembali ke dalam payload API baru.
- Simpan State Secara Lokal: Simpan memori obrolan di database lokal seperti PostgreSQL atau Redis ketimbang membebankan seluruh riwayat ke dalam parameter API.
Dengan menerapkan sistem jendela konteks yang terstruktur, aplikasi teman-teman tidak hanya menghemat kuota TPM harian, tapi juga mempercepat waktu respons model banyak karena token kosong yang diproses jauh lebih sedikit.
- Pangkas Pesan Lama: Hapus instruksi sistem yang sudah tidak relevan di tengah percakapan panjang.
- Gunakan Identifier Sesi: Pisahkan konteks antar user pakai ID unik agar tidak terjadi pencampuran data obrolan.
- Uji Efisiensi Payload: Lakukan pengujian ukuran payload pakai skrip unit test sebelum menerapkannya ke server production.
Mencegah Kebocoran API Key dan Eksploitasi Kunci Publik
Mengelola kuota Gemini API gratis bukan hanya soal trik teknis mengatasi rate limit, tapi juga menyangkut keamanan dasar dari kunci rahasia yang teman-teman miliki. Kunci API yang bocor di repository publik seperti GitHub bisa langsung disedot habis kuota hariannya oleh bot pemindai jahat dalam hitungan detik.
Ketika kunci API gratisan teman-teman dibajak pihak lain, kuota RPD dan TPM akan langsung ludes, dan aplikasi pribadi yang sedang dikembangkan akan terus-menerus menerima error 429 tanpa sebab yang jelas.
- Gunakan Variabel Lingkungan: Simpan kunci API di dalam file
.envDan pastikan untuk mendaftarkannya ke dalam.gitignorePada proyek Git. - Validasi Sisi Server: Jangan pernah memanggil Gemini API secara langsung dari kode sisi klien yang dapat dilihat oleh publik.
- Batasi Akses Kunci: Manfaatkan fitur pembatasan domain atau IP pada Google Cloud Console jika opsi tersebut tersedia untuk proyek teman-teman.
Dengan mengamankan kunci API sejak awal pengembangan, teman-teman dapat melindungi kuota harian dari penggunaan ilegal dan menjaga stabilitas operasional aplikasi tanpa gangguan eksternal yang merugikan.
- Rotasi Berkala: Ganti kunci API kalau dirasa ada aktivitas mencurigakan pada dashboard konsol.
- Gunakan Backend Mediator: Buat API endpoint sendiri sebagai perantara antara aplikasi klien dan server Google untuk menyembunyikan kunci rahasia.
- Pantau Log Akses: Periksa secara rutin daftar IP yang melakukan permintaan ke server teman-teman untuk mendeteksi tanda-tanda eksploitasi sejak dini.
Optimalisasi Parameter Generasi untuk Efisiensi Token
Selain ukuran prompt, parameter config sepertitemperature,top_p, danmax_output_tokensJuga penting dalam menentukan seberapa besar beban kuota yang dihabiskan oleh setiap pemanggilan API.
Baca juga Apa yang Baru di CursorBench 4.0? Bedah Long-Horizon Coding
Mengaturmax_output_tokensDengan bijak akan mencegah model menghasilkan teks jawaban yang terlalu panjang dan tidak perlu, yang pada akhirnya akan menyelamatkan kuota TPM harian dari pemborosan sia-sia.
- Batasi Output Token: Tentukan batas maksimal token keluaran secara eksplisit pada setiap permintaan agar model tidak keluar jalur dari inti jawaban.
- Atur Nilai Temperature Rendah: Gunakan nilai temperature mendekati 0 untuk tugas ekstraksi data atau klasifikasi agar respons lebih deterministik dan ringkas.
- Gunakan Stop Sequences: Tentukan kata kunci pemberhentian agar model langsung menghentikan proses pembuatan teks begitu jawaban utama selesai disampaikan.
Penerapan config parameter yang ketat ini sangat membantu dalam menjaga konsumsi token tetap berada di bawah ambang batas rate limit, sekaligus membuat respons aplikasi terasa jauh lebih gesit dan efisien.
- Uji Coba Parameter: Lakukan eksperimen kecil untuk menemukan kombinasi parameter terbaik antara akurasi jawaban dan konsumsi token.
- Hindari Jawaban Bertele-tele: Tambahkan instruksi sistem yang mewajibkan model memberikan jawaban singkat dan padat.
- Evaluasi Hasil Output: Periksa kembali apakah token keluaran benar-benar terpakai secara efektif untuk kebutuhan fungsional aplikasi.
Checklist
- Hitung estimasi token sebelum mengirim prompt panjang ke endpoint Gemini API
- Terapkan algoritma exponential backoff dan jitter saat menerima error 429
- Siapkan skema rotasi multiple API key di Python untuk sistem fallback mandiri
- Pilih model Flash untuk tugas berulang dan Pro khusus penalaran tingkat tinggi
- Aktifkan metode penagihan pay-as-you-go di Google Cloud Console saat aplikasi masuk public launch
- Manfaatkan pemrograman asinkron asyncio untuk memaksimalkan efisiensi batas RPM
- Bersihkan string input dari spasi berlebih dan gunakan format JSON minimalis
- Terapkan sistem caching lokal pakai Redis atau SQLite untuk data statis yang repetitif
- Batasi riwayat chat pakai sliding window agar ukuran payload tidak membengkak
- Simpan kunci API di dalam file .env dan daftarkan ke .gitignore pada proyek Git
Poin penting
- Pahami batasan RPM, TPM, dan RPD pada Gemini API free tier agar aplikasi tidak mendadak macet total.
- Hitung estimasi token dan batasi riwayat chat yang panjang untuk menghemat kuota harian.
- Terapkan algoritma exponential backoff saat menghadapi error 429 agar terhindar dari blokir server Google.
- Siapkan cadangan beberapa kunci API dari akun berbeda untuk mendistribusikan beban kerja secara otomatis.
- Manfaatkan model Flash yang menawarkan kuota harian lebih longgar dibanding varian Pro untuk uji coba.
- Pantau penggunaan kuota harian langsung melalui dashboard Google AI Studio .
Pertanyaan Umum
Berapa batas kuota harian dan menit untuk Gemini API free tier?
Mengapa aplikasi saya sering mengalami error 429 Too Many Requests?
Bagaimana cara mengatasi kuota harian yang cepat habis pada tier gratis?
Kapan waktu yang tepat untuk beralih dari free tier ke tier berbayar?
Apakah aman menyimpan API key langsung di dalam kode aplikasi sisi klien?
Kesimpulan
Mengelola batasan kuota pada Gemini API free tier menuntut kedisiplinan tinggi dalam merancang struktur payload dan mengatur lalu lintas request aplikasi. Pemahaman menyeluruh mengenai parameter RPM, TPM, dan RPD membantu teman-teman mengantisipasi lonjakan trafik sebelum memicu error 429 yang menghentikan sistem secara paksa. Pemanfaatan algoritma exponential backoff, rotasi kunci API cadangan, serta pemilihan varian model yang tepat terbukti efektif menjaga stabilitas operasional tanpa harus buru-buru merogoh kocek dalam.
Praktik optimalisasi seperti pemangkasan riwayat chat, penerapan caching lokal, dan penyimpanan kunci rahasia di dalam variabel lingkungan menjadi benteng pertahanan utama agar proyek tetap aman dari eksploitasi. Kalau aplikasi mulai masuk tahap peluncuran publik dan kebutuhan kuota melonjak konsisten, transisi ke tingkat berbayar di Google Cloud Console adalah langkah logis berikutnya. Selalu pantau penggunaan harian lewat dashboard untuk memastikan aplikasi tetap responsif dan efisien.
Komentar (0)
Belum ada komentar. Jadilah yang pertama berbagi pendapat!
Tinggalkan komentar