Kecerdasan Buatan
Nemotron 3.5 Bolt Resmi Rilis, AI Offline Cuma 4GB: Ini Spek dan Cara Cobanya
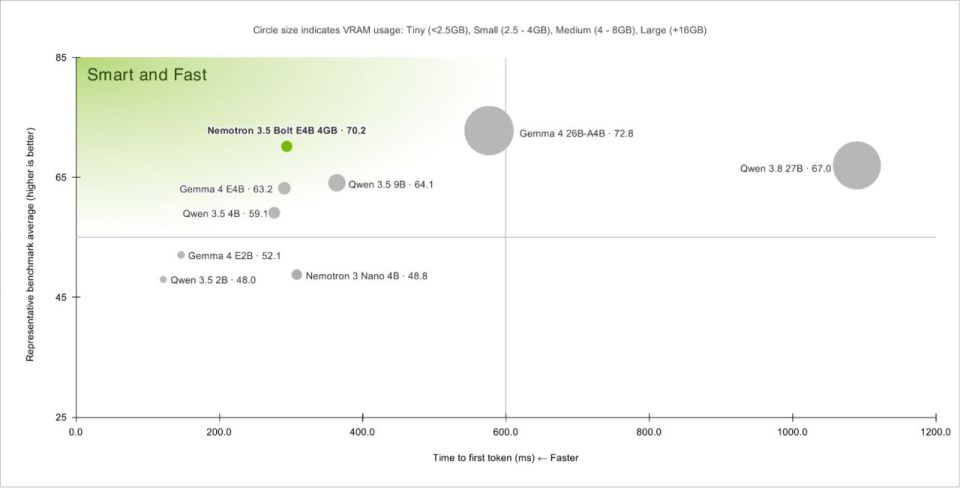
NVIDIA merilis Nemotron 3.5 Bolt E4B 4GB, model AI kecil gratis yang bisa jalan offline di laptop RTX. Ini spek, hasil benchmark, kebutuhan VRAM, dan cara menco
NVIDIA kembali merilis model AI terbuka, dan kali ini ukurannya sengaja dibuat kecil. Namanya Nemotron 3.5 Bolt E4B 4GB, diumumkan pada 23 Oktober 2026. Ini adalah model bahasa kecil yang dirancang untuk asisten suara, karakter game, sampai robot, dan bisa berjalan langsung di perangkat dengan memori sekitar 4GB saja.
Kabar ini menarik karena selama ini AI yang pintar identik dengan layanan cloud dan langganan bulanan. Artikel ini akan menjelaskan gambaran singkat Bolt E4B, spesifikasinya, hasil benchmark dibanding model sekelas, kebutuhan VRAM di kartu grafis RTX, cara mencobanya, serta catatan buat pengguna dan developer di Indonesia.
Nemotron 3.5 Bolt E4B itu model apa
Bolt E4B adalah model bahasa kecil (small language model) buatan NVIDIA yang dibangun di atas Gemma 4 E4B milik Google. NVIDIA lalu melatih ulang model dasar itu dengan resep post-training Nemotron supaya lebih jago ngobrol dan lebih rapi saat memanggil tool atau aplikasi.
Fokusnya bukan untuk menulis kode panjang atau riset berat. NVIDIA menyebut tiga kelompok kegunaan utama:
- Asisten perangkat dan suara, misalnya asisten di PC, aplikasi, rumah pintar, layanan pelanggan, sampai sistem di dalam mobil.
- Karakter interaktif, seperti NPC di game atau karakter pendamping yang tetap konsisten dengan kepribadiannya.
- Agen tertanam dan industri, misalnya antarmuka robot, mesin berat, dan IoT industri.
Menurut NVIDIA, banyak developer sebenarnya sudah bisa memakai model besar untuk kebutuhan ini. Masalahnya ada di memori, latensi, biaya, dan privasi. Karena itulah model kecil yang bisa jalan lokal jadi pilihan yang lebih masuk akal untuk produk sungguhan.
Catatan: Angka "4GB" di namanya merujuk ke target pemakaian memori sekitar 4GB pada beban kerja yang dituju, bukan ukuran file yang pasti sama di semua perangkat.
Spek dan fitur utama Bolt E4B
Di halaman resminya, NVIDIA merangkum beberapa fitur kunci. Semuanya diarahkan ke satu tujuan, yaitu asisten yang cepat, ringkas, dan bisa mengambil tindakan.
- Tool use multi-giliran: model bisa memanggil API aplikasi untuk menyelesaikan tugas di tengah percakapan, termasuk panduan untuk pemanggilan tool secara asinkron.
- Mode percakapan: sakelar khusus supaya jawaban lebih singkat dan enak diucapkan, cocok untuk asisten suara.
- Reasoning yang bisa diatur: mode berpikir bisa dinyalakan untuk permintaan rumit, atau dimatikan supaya respons lebih cepat. Panjang proses berpikirnya juga bisa dibatasi.
- Konteks 64 ribu token: cukup untuk menyimpan riwayat obrolan, instruksi, daftar tool, data hasil pencarian, dan status aplikasi.
- Multibahasa: mendukung 35 bahasa, dengan model dasar yang dilatih di lebih dari 140 bahasa.
Hal lain yang ditekankan NVIDIA adalah efisiensi jawaban. Bolt E4B disebut menghasilkan hingga 80% lebih sedikit token dibanding model pesaing saat mode reasoning aktif. Artinya, model tidak bertele-tele, sehingga respons bisa lebih cepat dan beban komputasi lebih ringan.
Demo: NPC pandai besi dan robot Reachy Mini
Supaya tidak cuma angka, NVIDIA memamerkan dua demo. Yang pertama adalah karakter pedagang pandai besi di dalam game. Agen ini memeriksa apakah pembayaran pemain sudah benar, lalu secara mandiri memanggil tool untuk mengecek resep, mengumpulkan bahan, membuat barang, dan menyerahkannya ke pemain.

Demo kedua memakai robot kecil Reachy Mini yang berjalan di Jetson Orin Nano 8GB. Di sini, model penglihatan Cosmos 3 Edge memberi pemahaman visual secara real-time, lalu Bolt E4B memutuskan animasi apa yang dijalankan robot sekaligus menyusun jawaban lisannya.
Dua contoh ini memperlihatkan arah yang dituju NVIDIA dengan cukup jelas:
- Model harus tahu kapan cukup ngobrol dan kapan perlu mengambil tindakan.
- Model harus patuh pada persona dan aturan yang diberikan developer.
- Model harus bisa membaca data lingkungan, seperti status game atau hasil tool, tanpa mengarang.
Hasil benchmark dibanding model sekelas
NVIDIA membandingkan Bolt E4B dengan tiga model kecil lain, yaitu Nemotron 3 Nano 4B (generasi sebelumnya), Qwen 3.5 4B, dan Gemma 4 E4B yang menjadi model dasarnya. Secara rata-rata, Bolt E4B disebut sekitar 40% lebih tinggi dibanding Nano 4B dan sekitar 10% lebih tinggi dibanding pesaing lain yang diuji.
Berikut beberapa angka yang paling mudah dipahami:
| Benchmark | Yang diukur | Bolt E4B | Nano 4B | Qwen 3.5 4B | Gemma 4 E4B |
|---|---|---|---|---|---|
| Brevity Bench | Kualitas dan keringkasan jawaban | 82,5 | 73,6 | 75,3 | 80,0 |
| MultiChallenge | Konsistensi antar giliran | 53,1 | 35,3 | 51,8 | 42,1 |
| RoleMRC | Patuh pada identitas peran | 80,6 | 47,0 | 65,8 | 74,6 |
| When2Call-MT | Tahu kapan memanggil tool | 63,4 | 27,7 | 37,8 | 62,9 |
| IHEval | Prioritas instruksi | 84,8 | 51,3 | 60,6 | 67,0 |
| Tau2-Bench | Tugas layanan pelanggan | 55,1 | 29,2 | 75,1 | 38,5 |
| LongBench v2 | Memahami prompt panjang | 50,5 | 31,4 | 59,9 | 49,3 |

Dari tabel itu terlihat bahwa Bolt E4B unggul di urusan percakapan, persona, dan kepatuhan instruksi. Namun, model ini tidak menang di semua tes. Qwen 3.5 4B masih lebih kuat di Tau2-Bench, LongBench v2, dan RULER 64K. Jadi, kalau kebutuhannya lebih ke membaca dokumen panjang, Bolt E4B belum tentu pilihan terbaik.
Catatan: Brevity Bench dan When2Call-MT adalah benchmark baru yang menurut NVIDIA baru akan dirilis belakangan, jadi hasil pada dua tes ini belum bisa diuji ulang oleh pihak lain.
Kebutuhan VRAM dan kecepatan di RTX dan Jetson
Bagian ini yang paling penting buat yang ingin mencoba di laptop atau PC sendiri. NVIDIA mengukur versi kuantisasi Q4_K_M dengan llama.cpp pada batch size 1. Hasilnya cukup ringan:
| Perangkat | VRAM terpakai | Waktu token pertama | Kecepatan |
|---|---|---|---|
| RTX 5070 (12GB), prompt 3K | 3,5 GB | 548 ms | 133,4 token/detik |
| RTX 5070 (12GB), cache 32K | 4,3 GB | 1.238 ms | 106,2 token/detik |
| RTX Spark (32GB), prompt 3K | 3,1 GB | 930 ms | 67,0 token/detik |
| Jetson Orin Nano (8GB), prompt 3K | 4,2 GB | 5.785 ms | 15,5 token/detik |
| Jetson AGX Orin (32GB), prompt 3K | 4,2 GB | 3.687 ms | 24,0 token/detik |
Angka di RTX 5070 menarik karena pemakaian VRAM hanya sekitar 3,5–4,3GB. Itu berarti masih ada sisa memori untuk game, aplikasi lain, atau model tambahan seperti pengenal suara. Sebagai perbandingan, NVIDIA juga mencantumkan referensi model cloud seperti Gemini 3.8 Flash dan Claude Sonnet 5.5 yang waktu token pertamanya di kisaran 2,4–3 detik pada pengujian mereka.

NVIDIA juga menyertakan DFlash, model drafter yang menebak beberapa token sekaligus lalu diverifikasi model utama. Menurut NVIDIA, DFlash memberi throughput hingga 21% lebih tinggi dibanding drafter bawaan Gemma 4 E4B.
Cara mencoba Nemotron 3.5 Bolt di PC sendiri
Kabar baiknya, model ini terbuka dan sudah tersedia di beberapa platform populer. NVIDIA menyebut Bolt E4B bisa didapat lewat Hugging Face, Ollama, LM Studio, Unsloth, Canonical, Jetson AI Lab, dan NVIDIA In-Game Inferencing SDK.
Baca juga Underdog, Aplikasi AI Offline untuk Laptop RTX Spark: Fitur, Syarat, dan Cara Mulai
Untuk pengguna biasa, jalur paling gampang biasanya seperti ini:
- Cek kartu grafis. Siapkan PC atau laptop dengan GPU yang punya VRAM minimal sekitar 6GB supaya ada ruang lega di atas kebutuhan ~4GB.
- Pasang LM Studio atau Ollama. Keduanya punya aplikasi desktop untuk Windows, macOS, dan Linux.
- Cari model "Nemotron 3.5 Bolt E4B". Pilih versi GGUF Q4_K_M yang dipakai NVIDIA dalam pengujian.
- Unduh dan jalankan. Setelah file selesai diunduh, model bisa dipakai ngobrol tanpa koneksi internet.
- Atur mode. Developer bisa mengaktifkan mode percakapan atau mematikan reasoning untuk respons yang lebih cepat.
Untuk developer, NVIDIA menyediakan empat checkpoint, yaitu versi GGUF, drafter DFlash untuk GGUF, versi BF16 untuk Hugging Face, dan drafter DFlash NVFP4. Resep training dan dataset yang dipakai juga dibuka.
Tips: Nama model di Ollama atau LM Studio bisa sedikit berbeda dari nama resmi. Pastikan sumbernya dari akun resmi NVIDIA supaya tidak salah unduh model tiruan.
Yang relevan buat pengguna dan developer di Indonesia
Buat pengguna di Indonesia, ada beberapa hal yang membuat Bolt E4B layak dilirik:
- Gratis dan offline. Model terbuka berarti tidak perlu bayar langganan dalam dolar atau mengandalkan koneksi internet yang stabil.
- Ramah laptop gaming kelas menengah. Kebutuhan memori sekitar 4GB membuat banyak laptop RTX yang sudah beredar di sini bisa mencobanya.
- Data tetap di perangkat. Ini penting buat UMKM atau kantor yang ragu mengirim data pelanggan ke server luar negeri.
- Peluang buat studio game lokal. NPC yang bisa ngobrol dan bertindak tanpa server cloud bisa menekan biaya operasional game.
Soal bahasa, NVIDIA hanya menyebut dukungan 35 bahasa tanpa merinci daftarnya di halaman pengumuman. Jadi, apakah Bahasa Indonesia sudah lancar atau belum perlu dicek sendiri. Model dasarnya, Gemma 4, dilatih di lebih dari 140 bahasa, sehingga ada peluang hasilnya cukup baik, tetapi tetap sebaiknya diuji dengan prompt sehari-hari sebelum dipakai di produk.
Batasan yang perlu diperhatikan
Meski menjanjikan, Bolt E4B tetap model kecil. Ada beberapa batasan yang sebaiknya dipahami sejak awal:
- Bukan pengganti model besar. Untuk coding rumit, analisis panjang, atau riset, model cloud kelas atas masih jauh lebih kuat.
- Tidak unggul di semua benchmark. Di tes konteks panjang dan tugas layanan pelanggan multi-langkah, Qwen 3.5 4B masih lebih baik.
- Sebagian benchmark belum terbuka. Dua tes buatan NVIDIA belum dirilis, sehingga klaimnya belum bisa dibuktikan pihak lain.
- Optimal di hardware NVIDIA. Angka kecepatan diukur di RTX dan Jetson. Performa di perangkat lain belum tentu sama.
Dengan kata lain, Bolt E4B paling cocok untuk asisten yang perlu cepat, ringkas, dan patuh aturan, bukan untuk semua jenis pekerjaan AI.
Poin penting
- NVIDIA merilis Nemotron 3.5 Bolt E4B 4GB pada 23 Oktober 2026 sebagai model AI kecil yang terbuka.
- Model ini dibangun di atas Gemma 4 E4B dan dioptimalkan untuk asisten, karakter game, dan robot.
- Fiturnya mencakup tool use, mode percakapan, reasoning yang bisa diatur, konteks 64K, dan 35 bahasa.
- Pemakaian VRAM di RTX 5070 hanya sekitar 3,5–4,3GB dengan kecepatan lebih dari 100 token per detik.
- Bisa dicoba lewat Ollama, LM Studio, Hugging Face, dan platform lain secara gratis.
Referensi
- NVIDIA Research (2026). Introducing NVIDIA Nemotron 3.5 Bolt E4B 4GB
- NVIDIA (2026). Nemotron 3.5 Bolt E4B 4GB Technical Report
- Hugging Face (2026). NVIDIA-Nemotron-3.5-Bolt-E4B-4GB Model Card
- NVIDIA (2026). NeMo-RL dan NeMo-Gym Training Recipes
- Google (2026). Gemma 4 E4B Model Overview
- NVIDIA (2026). Jetson AI Lab
- Ollama (2026). Model Library
Pertanyaan Umum
Apakah Nemotron 3.5 Bolt E4B gratis?
Berapa VRAM yang dibutuhkan untuk menjalankan Bolt E4B?
Apakah Bolt E4B bisa jalan tanpa internet?
Apa bedanya dengan Gemma 4 E4B?
Apakah Bolt E4B mendukung Bahasa Indonesia?
Kesimpulan
Nemotron 3.5 Bolt E4B 4GB menunjukkan bahwa AI yang cepat dan cukup pintar tidak selalu butuh server besar. Dengan kebutuhan memori sekitar 4GB, model ini membuka jalan bagi asisten offline, NPC game yang bisa bertindak, dan robot kecil yang responsif.
Buat pengguna laptop RTX di Indonesia, ini salah satu cara paling murah untuk mencoba AI lokal tanpa langganan. Yang perlu diingat, model ini paling bersinar untuk percakapan dan tugas ringkas, jadi untuk pekerjaan berat tetap butuh model yang lebih besar.
Komentar (0)
Belum ada komentar. Jadilah yang pertama berbagi pendapat!
Tinggalkan komentar